
FLUX 3
画像、ビデオ、サウンドを 1 つのモデルで対応
FLUX 3は、Black Forest Labsのマルチモーダル基盤モデルです。1つの統合アーキテクチャで、画像、動画、音声をまとめて学習しています。同社初の動画モデルでもあり、1回の処理で音声付きの映像を最大20秒生成します。Pexoで利用できます。
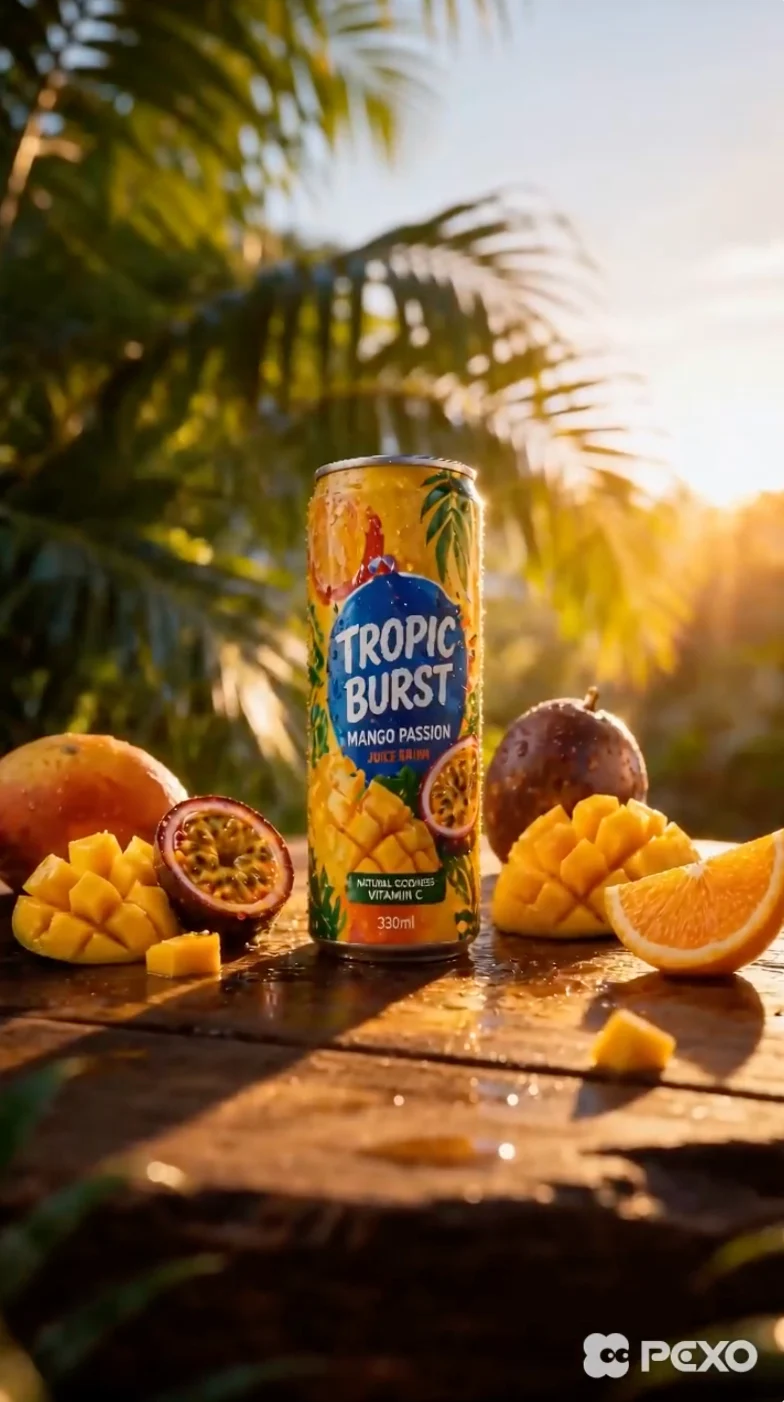
Pexoで生成したFLUX 3の作例
ここに掲載した動画はすべて、普段の言葉で説明してPexoで作成したものです。プロンプトの書式やモデルの設定は必要ありません。
FLUX 3 の違い
Black Forest Labsは、2026年7月23日にFLUX 3を公開しました。画像専用だった従来のFLUXシリーズとは異なり、設計にも特徴的な選択を取り入れています。
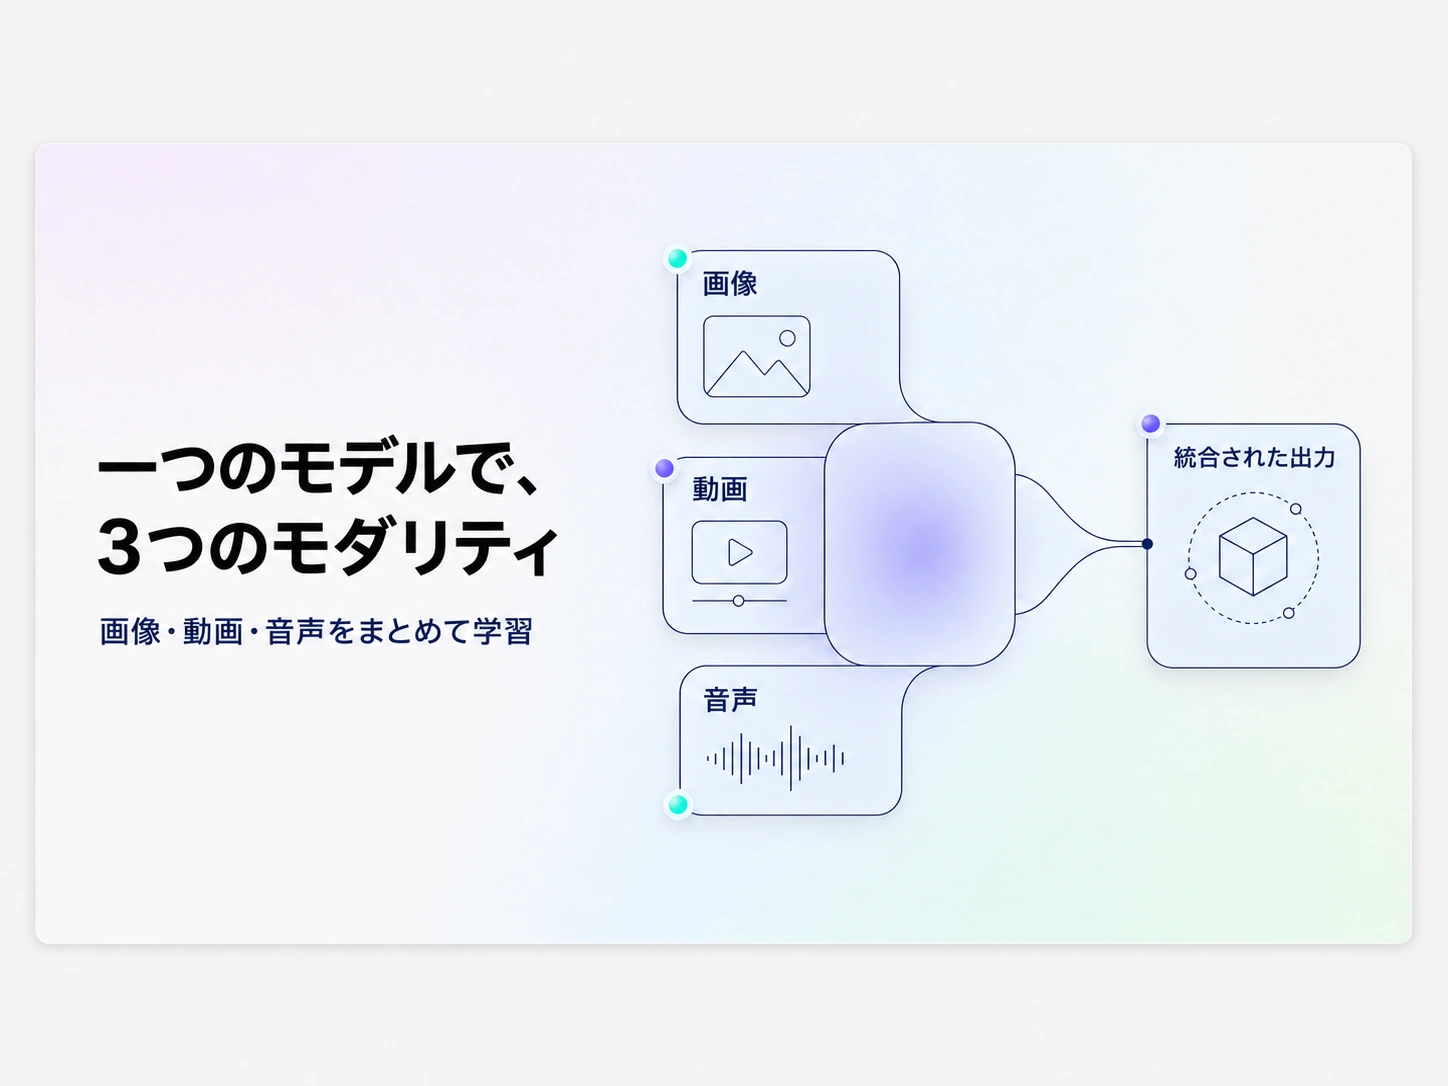
3つのモデルをまとめるのではなく、1つのアーキテクチャで
FLUX 3はSelf-Flowを基盤としています。Black Forest Labsによると、同じ基盤アーキテクチャの中で、複数種類のデータの生成と理解を効率的に整合させる手法です。画像、動画、音声、言語は、根底にある同じ現実を異なる形で表したものと捉え、別々のモデルを組み合わせるのではなく、まとめて学習します。
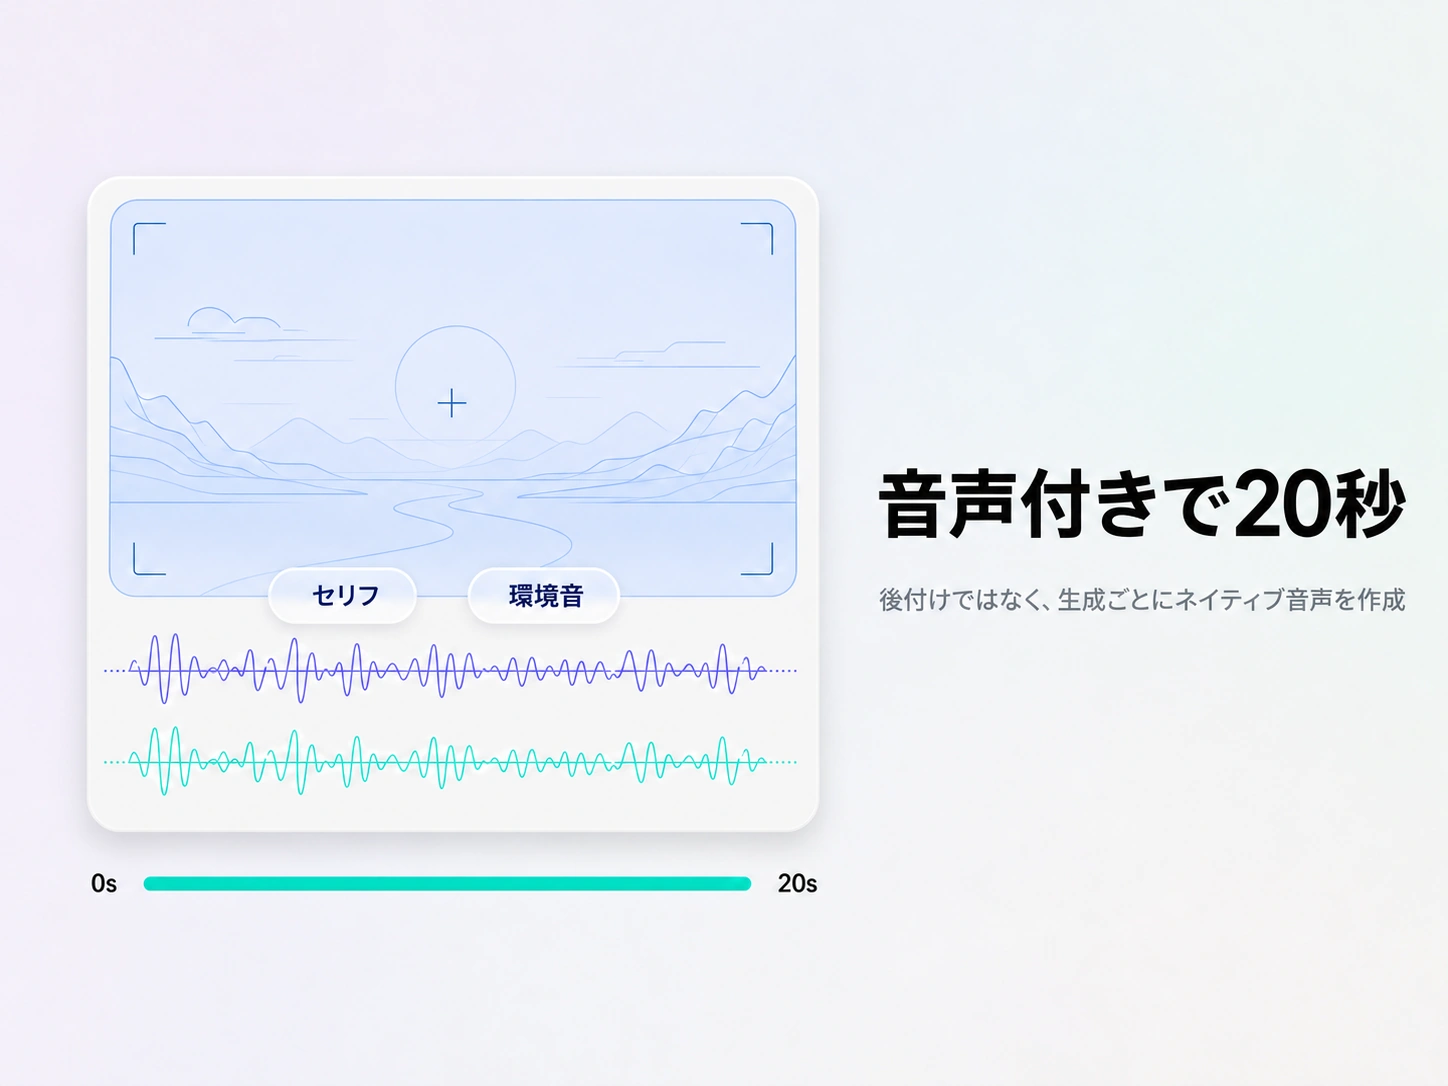
最大 20 秒、デフォルトで音声が含まれます
Black Forest Labs初の動画モデルで、1回の生成で音声付きの映像を最大20秒作れます。音声生成は有効化する追加機能ではなく、すべての出力に含まれ、セリフ、効果音、環境音を映像と一緒に生成します。
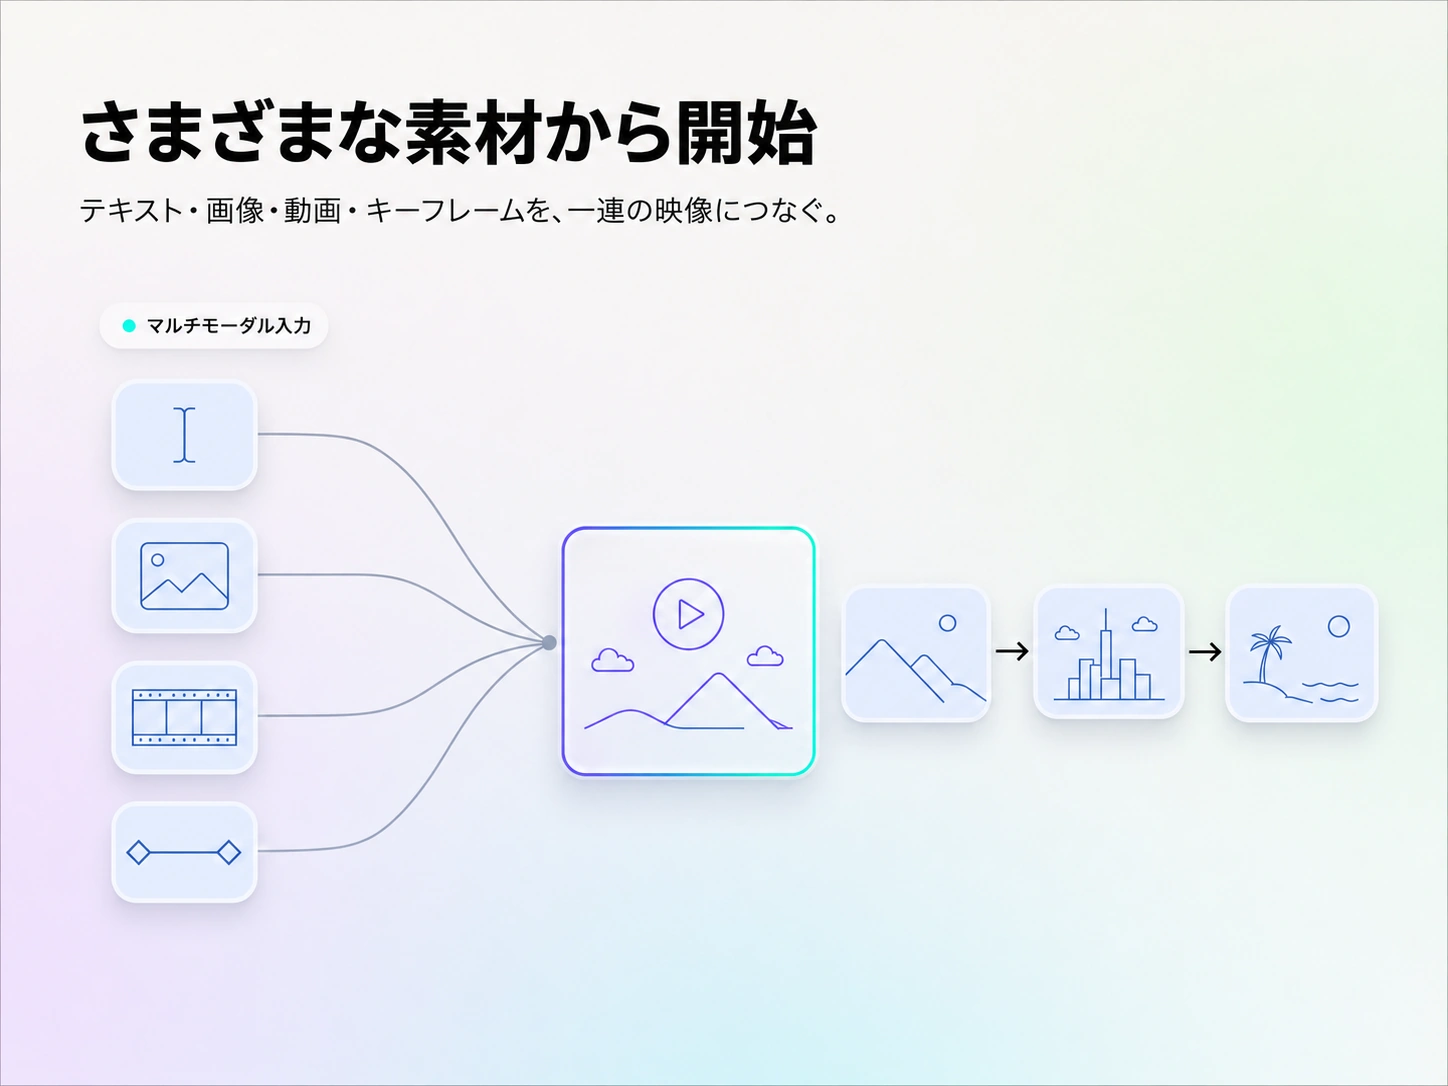
テキスト、画像、動画、キーフレームを出発点に
FLUX 3は、テキストからの動画生成、動きを付けたり見た目を参照したりする画像からの動画生成、動画からの動画生成、動画・音声の続きを作る処理、キーフレームからの動画生成、多言語のセリフに対応します。1ショットずつに限らず、エージェントで個々の生成をつなぎ、複数ショットの映像を組み立てられます。
FLUX 3と従来のFLUXモデルを比較
従来のFLUXはすべて画像モデルでした。FLUX 3で、Black Forest Labsはシリーズをマルチモーダル基盤モデルへと広げました。そのため、品質の点数よりも、モデルの用途の違いが比較の中心になります。
| 機能 | FLUX 3 | FLUX.2 | FLUX.1 | FLUX.1 Dev |
|---|---|---|---|---|
| 位置付け | マルチモーダル基礎モデル | 画像生成 | 画像生成 | 画像生成 |
| 動画生成 | ✓ | — | — | — |
| 画像付きネイティブ音声 | ✓ | — | — | — |
| ロボット工学のための行動予測 | ✓ | — | — | — |
| モダリティを超えて共同トレーニング | ✓ | — | — | — |
| アーキテクチャ | Self-Flowによる統合構造 | イメージフローモデル | イメージフローモデル | イメージフローモデル |
出典: Black Forest Labs: FLUX 3 · Black Forest Labs · BFL ドキュメント
Pexo で FLUX 3 を使用する方法: 3 つのステップ、セットアップなし
アカウント、APIキー、技術的な知識は必要ありません。Pexoがモデルの選択、生成、納品まで対応するので、作りたいものに集中できます。
Web、Telegram、WhatsApp、Discordで、作りたい内容を普段の言葉で入力します。決まった形式やモデルの選択は不要です。Pexoが意図を読み取り、残りの処理を行います。
PexoがリクエストをFLUX 3に送り、適切な設定を自動で適用し、生成を実行します。設定作業は必要ありません。
そのまま使える状態の動画が届きます。調整したいときも、最初からやり直さずに、同じ会話を続けて指示できます。
Pexo の FLUX 3 で何が作れるか
プロンプトを書いたり、モデルを選んだりする必要はありません。作りたいものを言葉で伝えるだけです。
FLUX 3 に関するよくある質問
FLUX3とは何ですか?+
FLUX 3は、Black Forest Labsが2026年7月23日に発表したマルチモーダル基盤モデルです。1つの統合アーキテクチャの中で画像、動画、音声をまとめて学習し、同社で初めて動画を生成するモデルです。同社は、画像、動画、音声、言語という4つの形式を、根底にある同じ現実の異なる表れと捉えています。
FLUX 3 ビデオの長さはどれくらいですか? サウンドはありますか?+
Black Forest Labsによると、FLUX 3は1回の生成で最大20秒の音声付き動画を作り、すべての出力に音声生成が含まれます。分析用に公開された初期のクリップは、720p・10秒で音声付きです。
Self-Flowとは何ですか?+
Self-Flowは、Black Forest Labsが開発した、同じ基盤アーキテクチャ内で複数種類のデータの生成と理解を効率的に整合させる手法です。FLUX 3の基盤であり、専用モデルを別々につなぐのではなく、1つのモデルで画像、動画、音声を同時に学習できます。
FLUX 3 は FLUX.2 や FLUX.1 とどう違うのですか?+
従来のFLUXは画像モデルでした。FLUX 3は、画像、動画、音声、動作予測を1つのアーキテクチャで扱うマルチモーダル基盤モデルです。Black Forest Labsによると、FLUX 3 Imageは、特に複雑なプロンプトの処理や多言語の文字生成で、従来版より大幅な改善を示しています。
FLUX 3には、どのような種類がありますか?+
4種類あります。FLUX 3 Videoは動画と音声の生成・編集、FLUX 3 Imageは画像の生成・編集を扱います。FLUX-mimicとも呼ばれるFLUX 3 Actionは動作予測を扱い、mimic roboticsをはじめとする選定パートナーを通じて提供されます。FLUX 3 Devは、重みの公開を予定しているマルチモーダルの基盤モデルです。
FLUX 3 を今すぐ使用できますか?+
段階的に提供されます。Black Forest LabsはFLUX 3を早期アクセスとして公開し、まずFLUX 3 Video、その後数週間でFLUX 3 Imageを提供する予定としています。動作予測は選定パートナーを通じて提供され、重み公開のDev版は今後の展開が予定されています。同社は、公表した評価値や仕様を暫定的なものと説明しています。
PexoのFLUX 3で、言葉を映像に
今利用できる最高の動画モデルを、1文の説明で使えます。