
GPT-Image-2。
Pexoで利用可能に。
GPT-Image-2は、OpenAIの最も高性能な画像生成モデルです。写真のような表現、指示への忠実さ、生成画像内の文字を正確で読みやすく描く能力が大きく進歩しています。Pexoでは、作りたいものを普段の言葉で説明するだけで利用できます。APIの設定や、プロンプトの書式を覚える必要はありません。
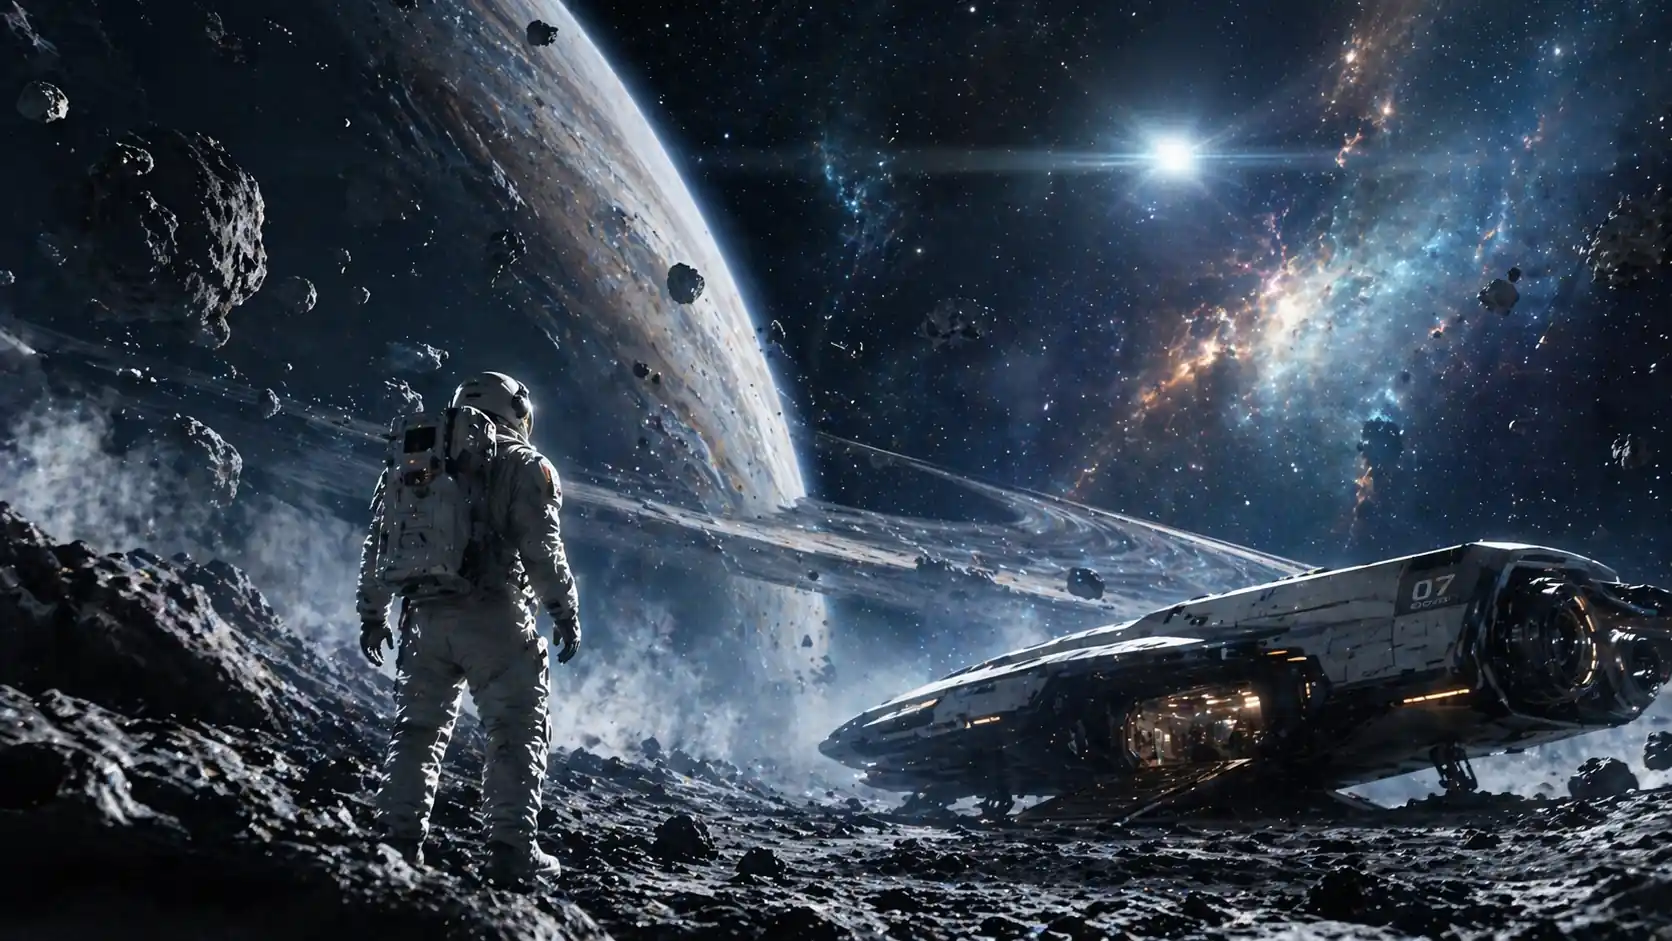
Pexoで生成したGPT-Image-2の作例
ここに掲載した画像はすべて、特別なプロンプト形式やモデル設定を使わず、普段の言葉で説明してPexoで作成したものです。Pexoのユーザーなら、初回の生成からこの品質の画像を作れます。
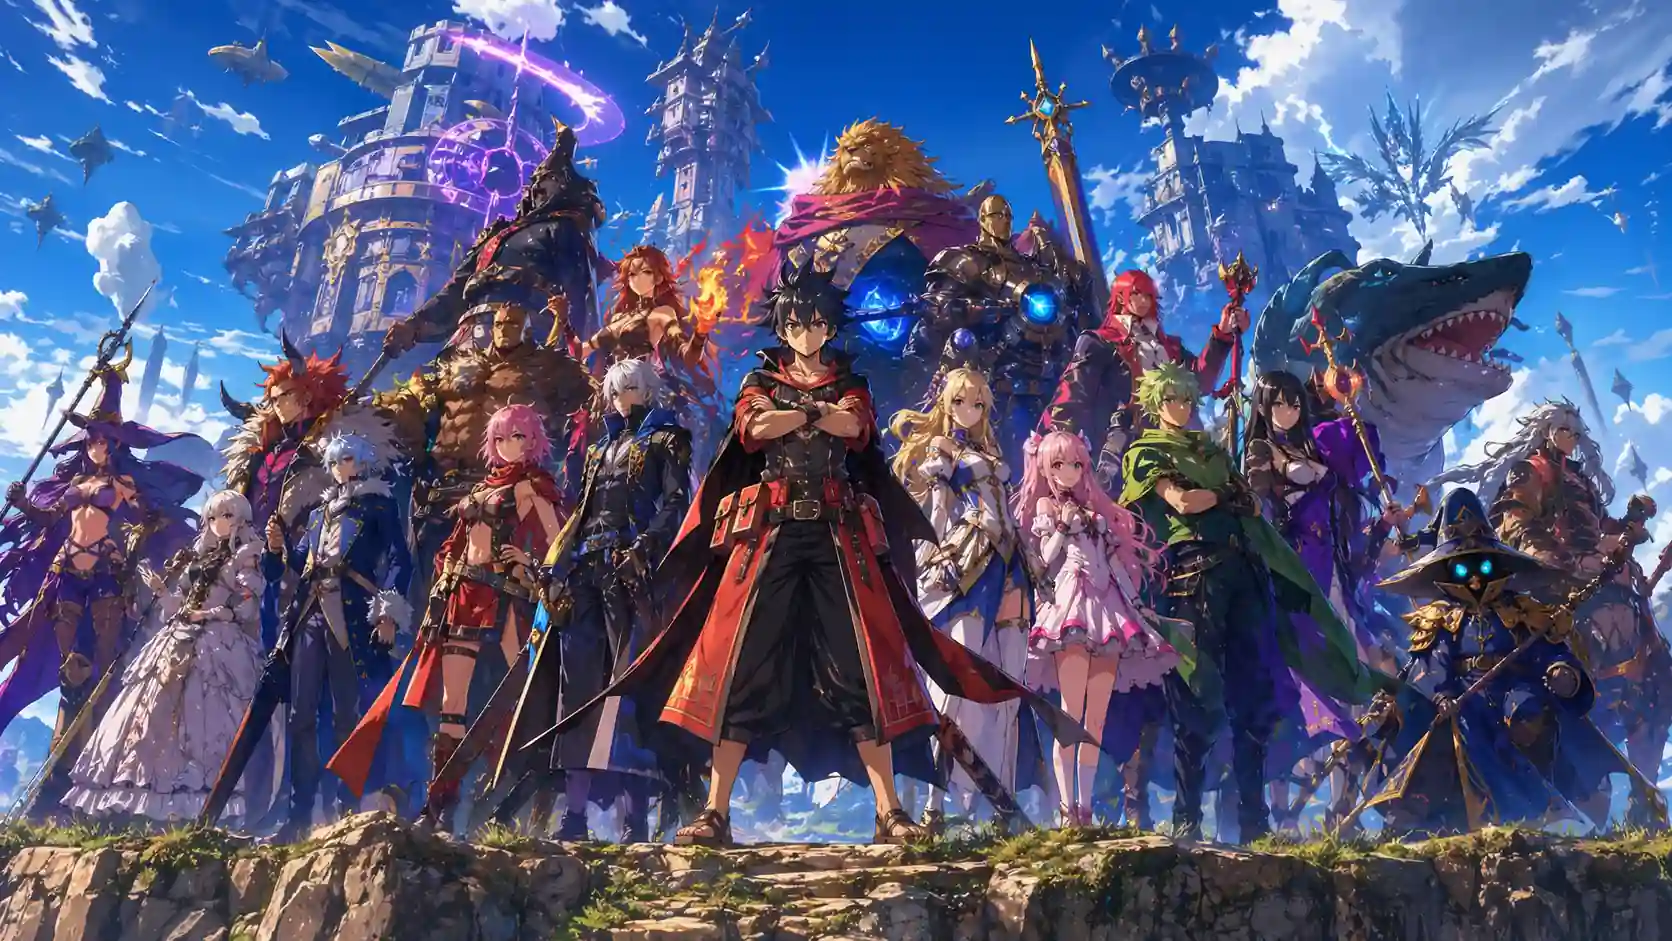
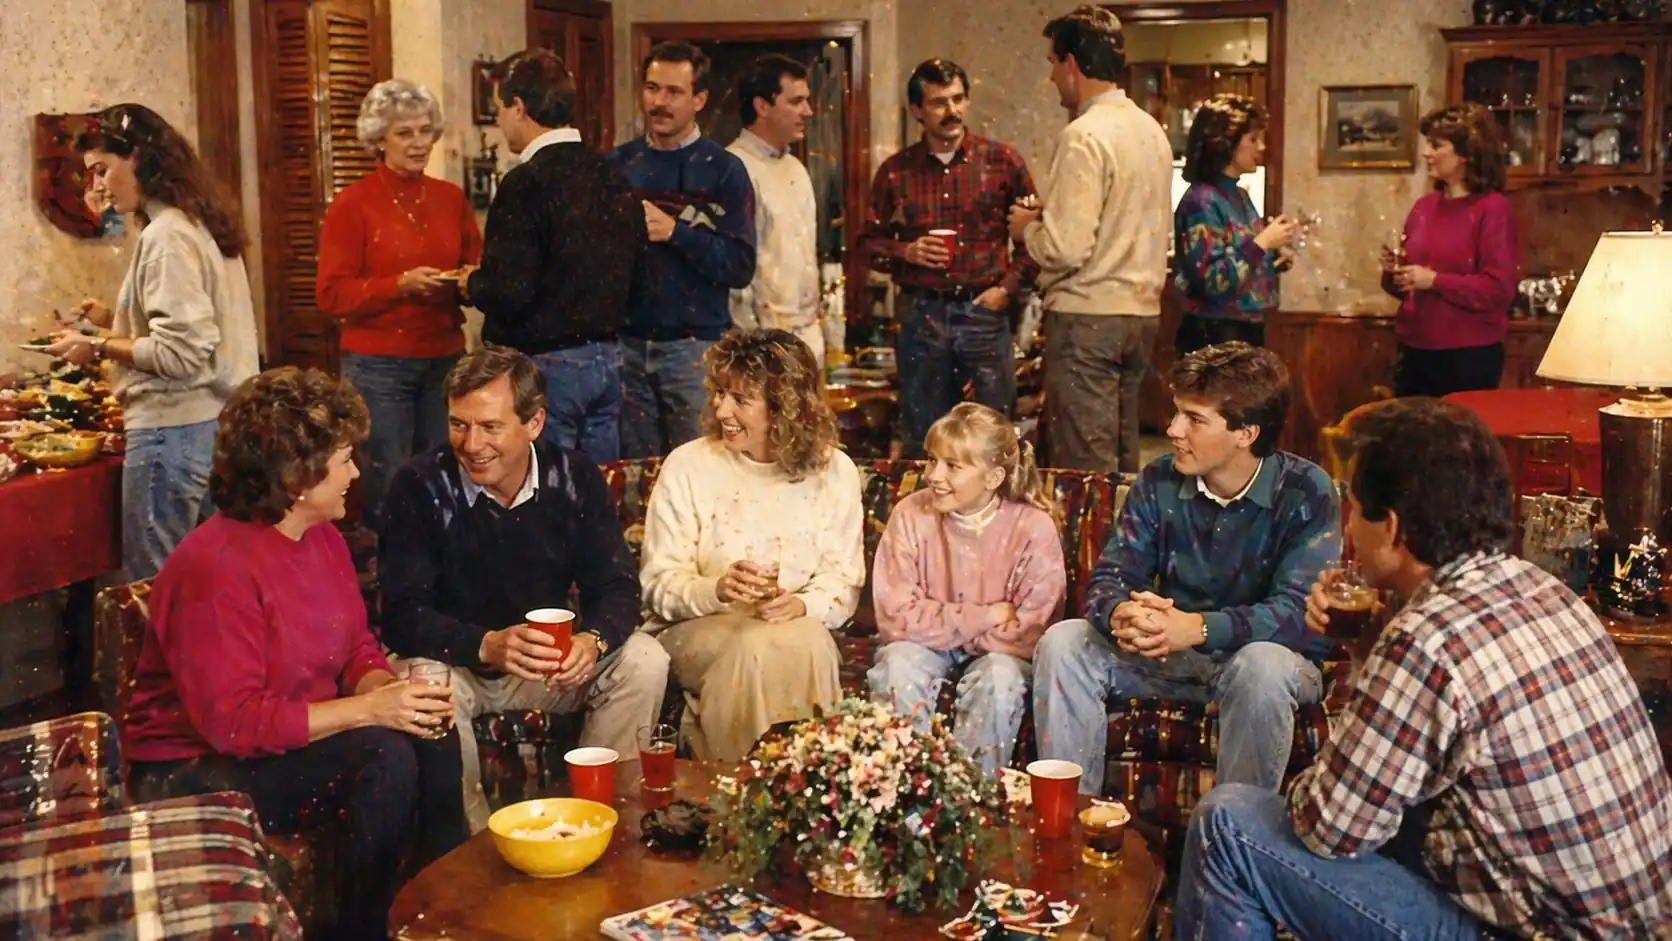
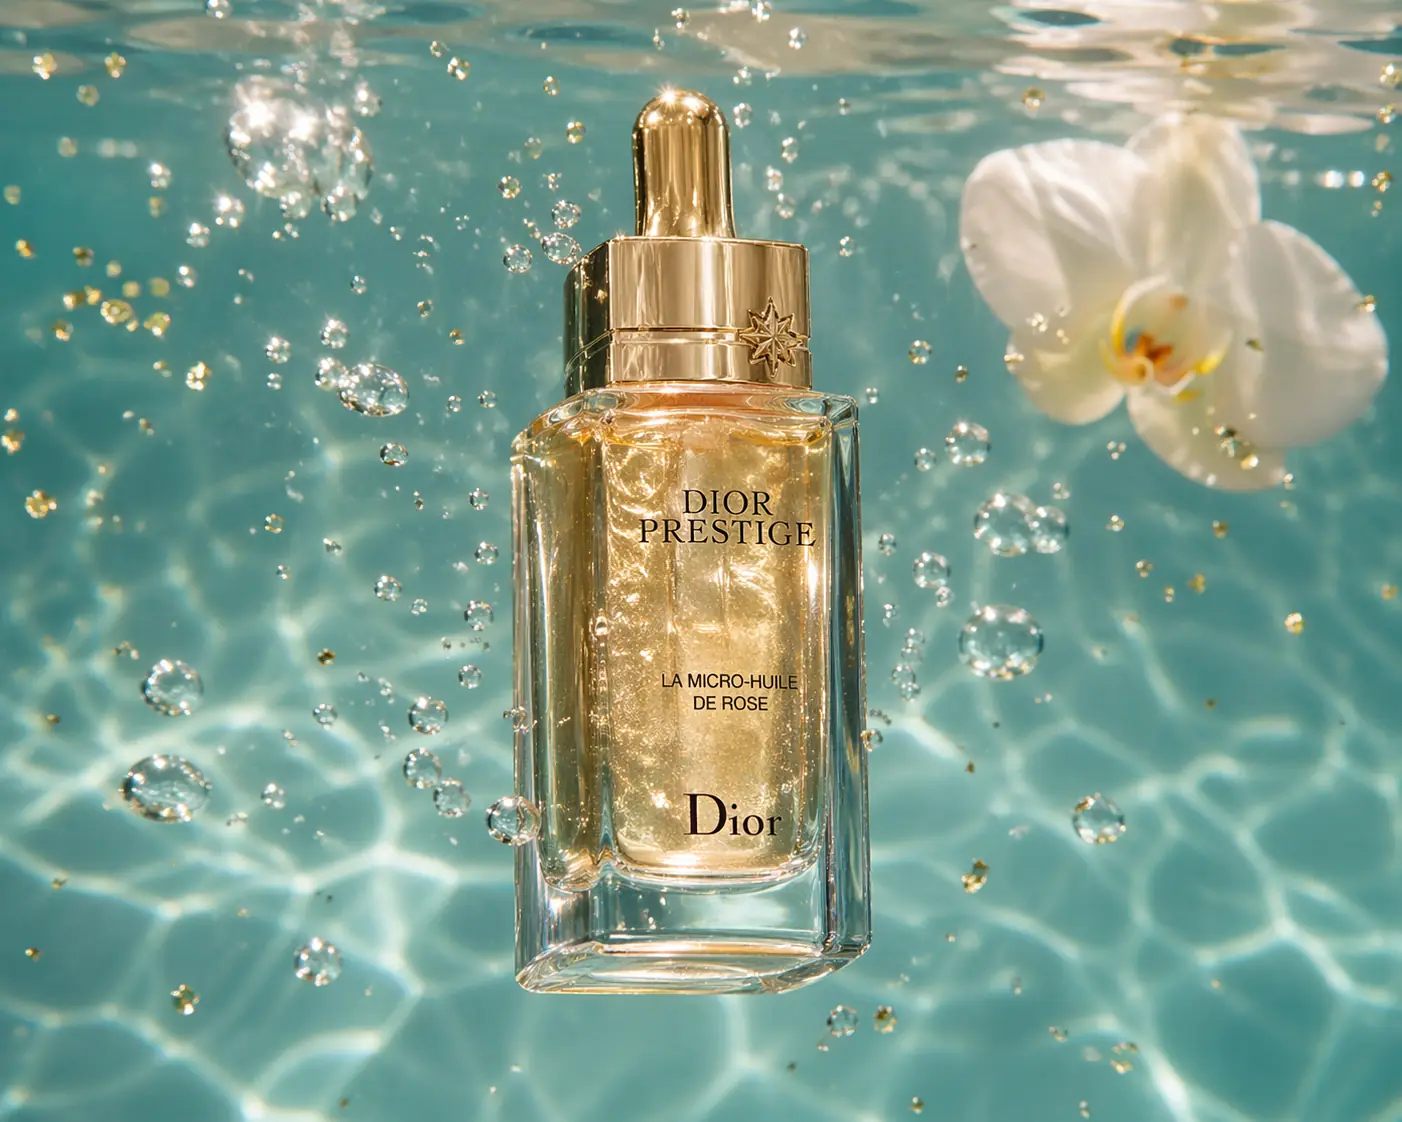
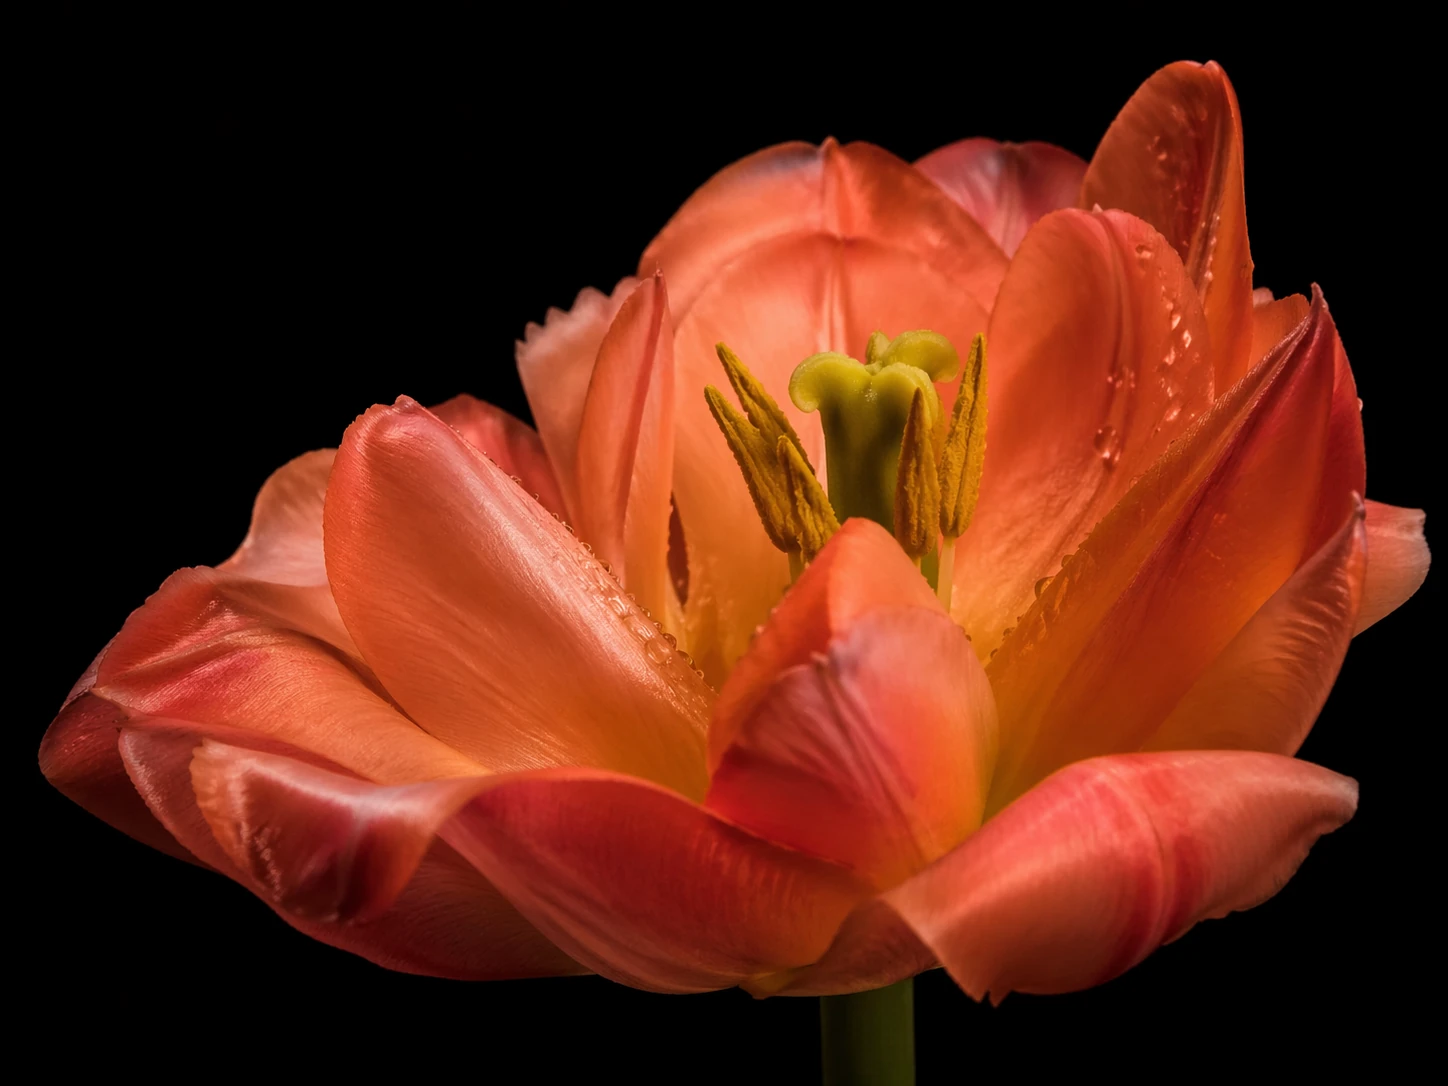
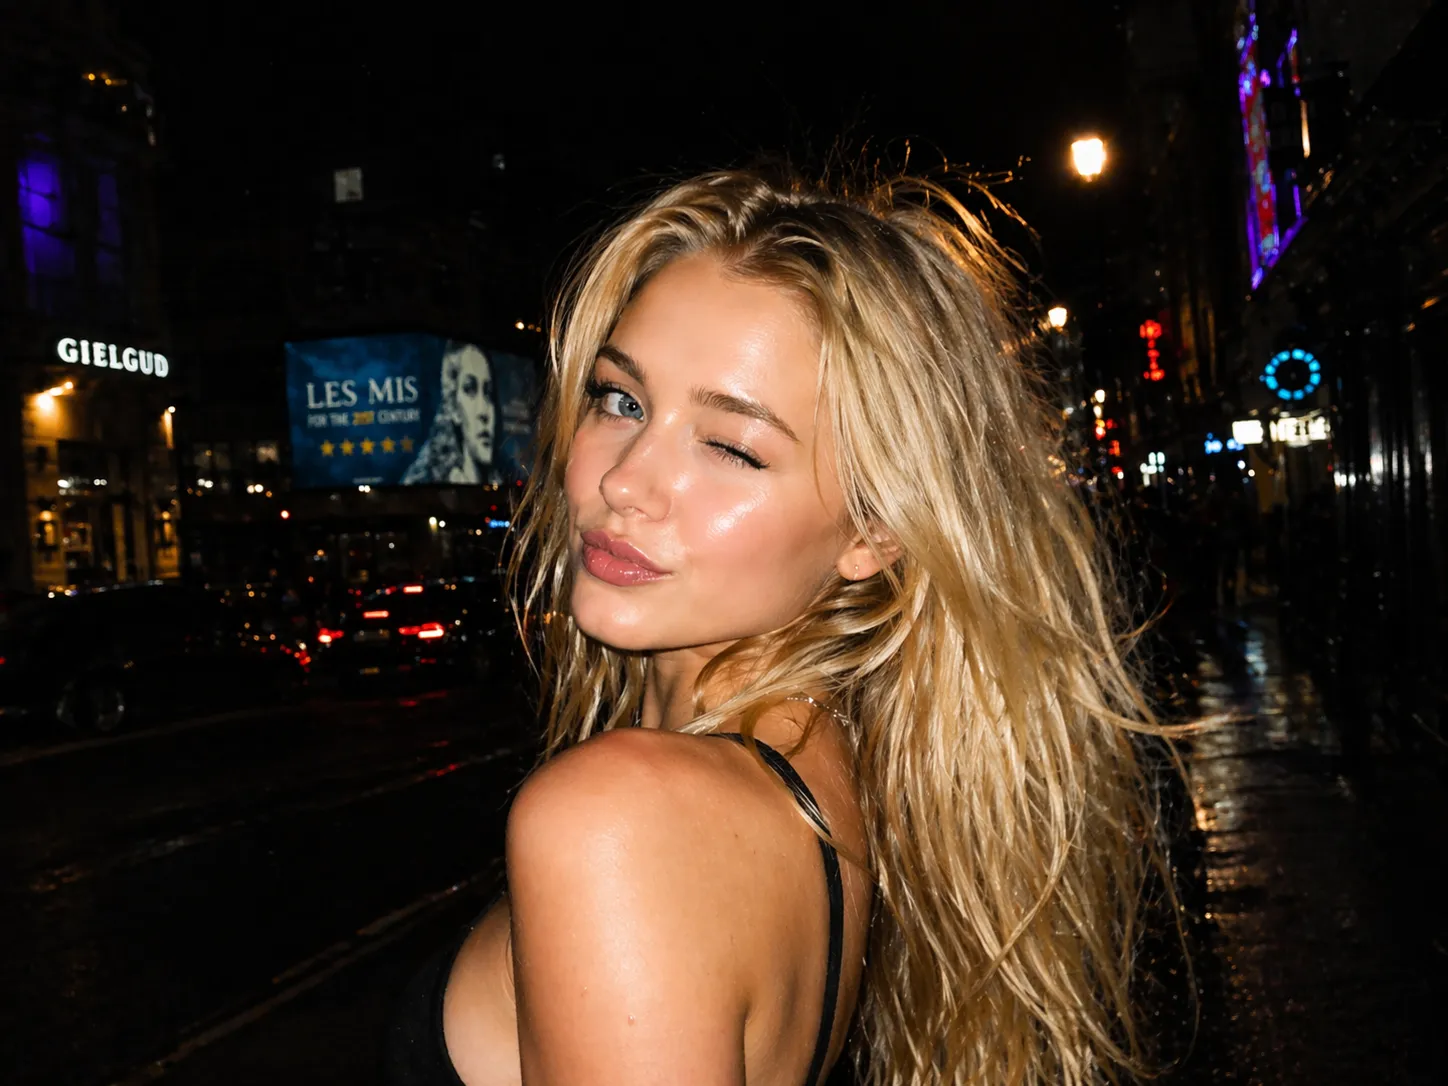
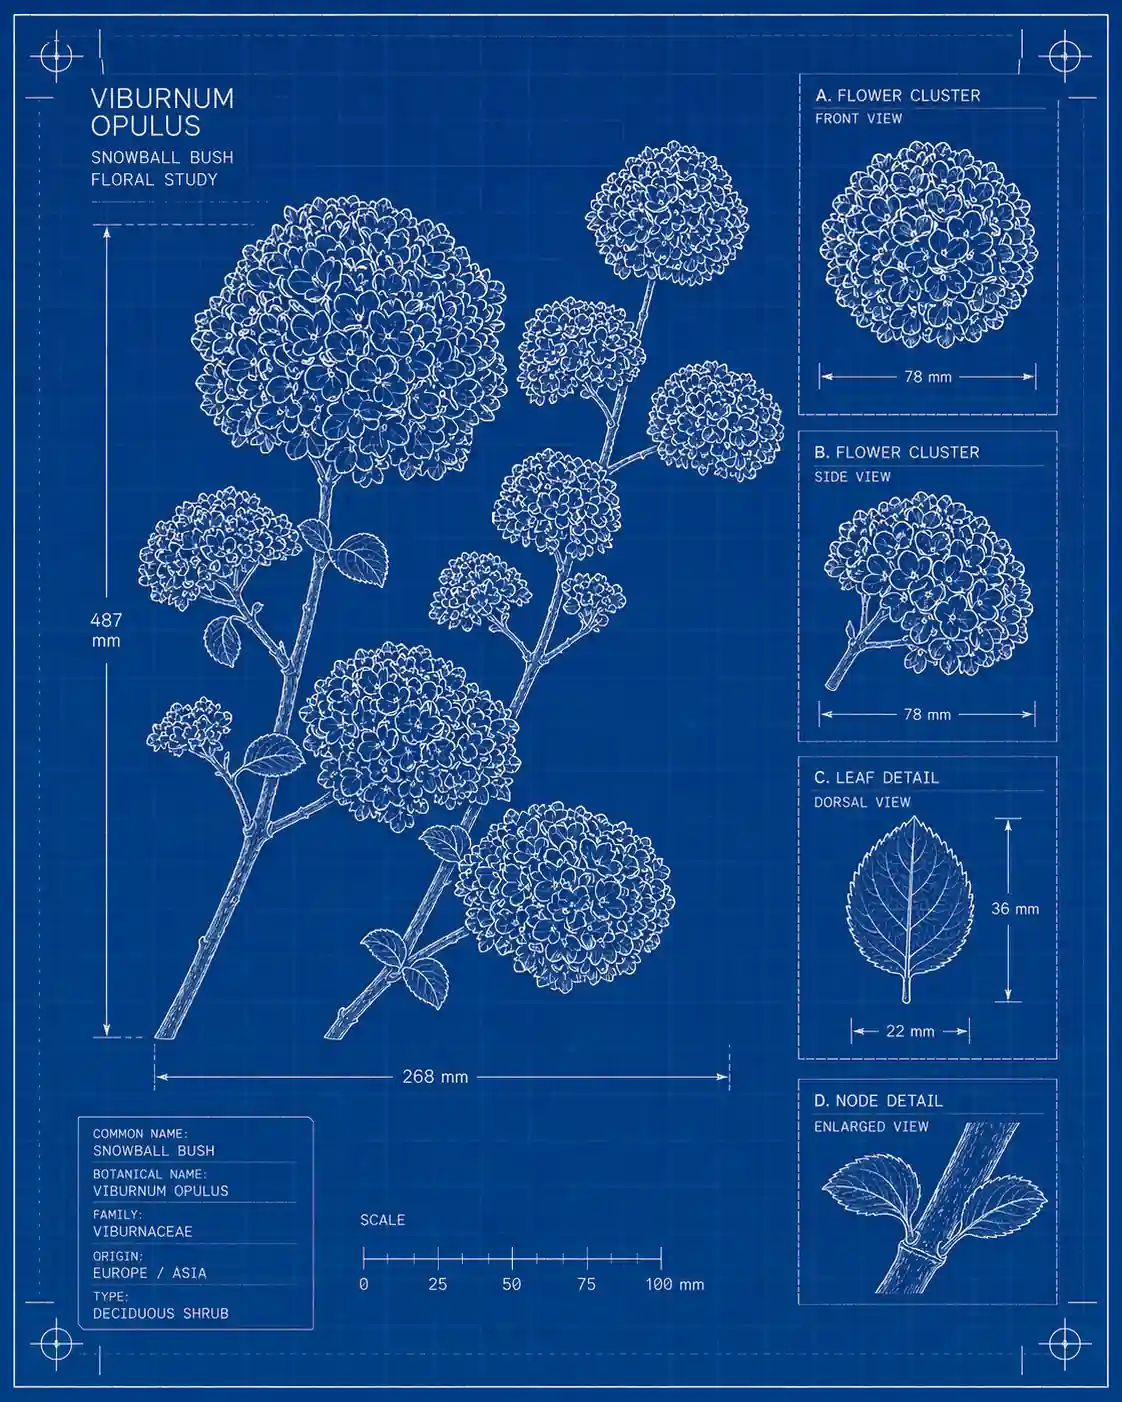
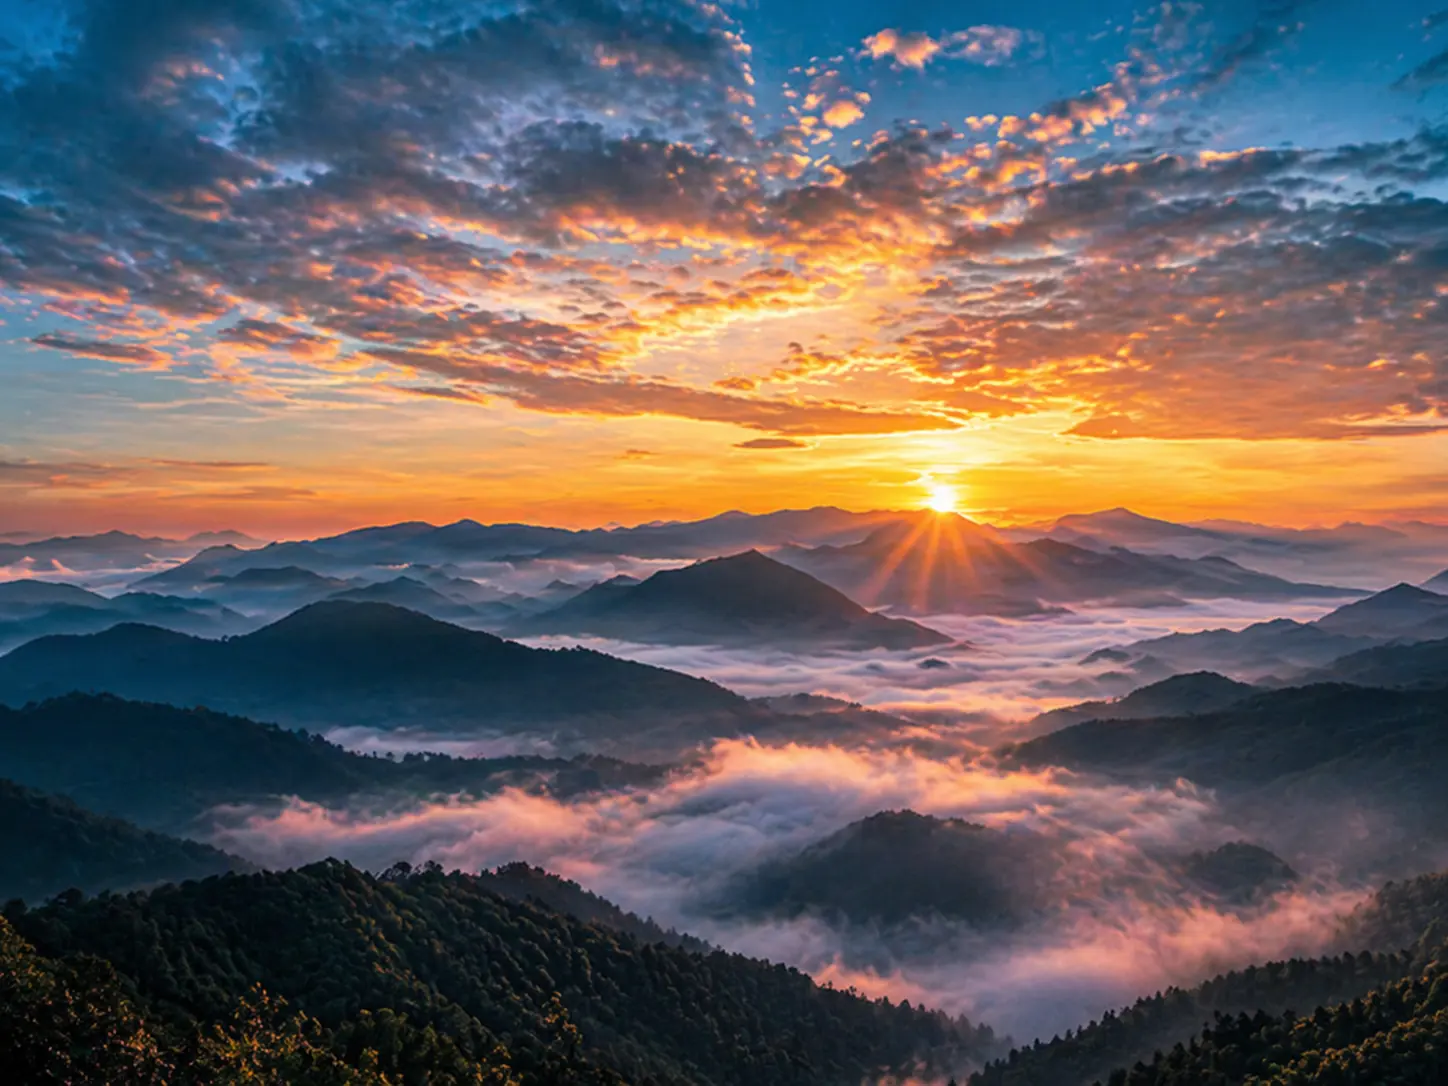
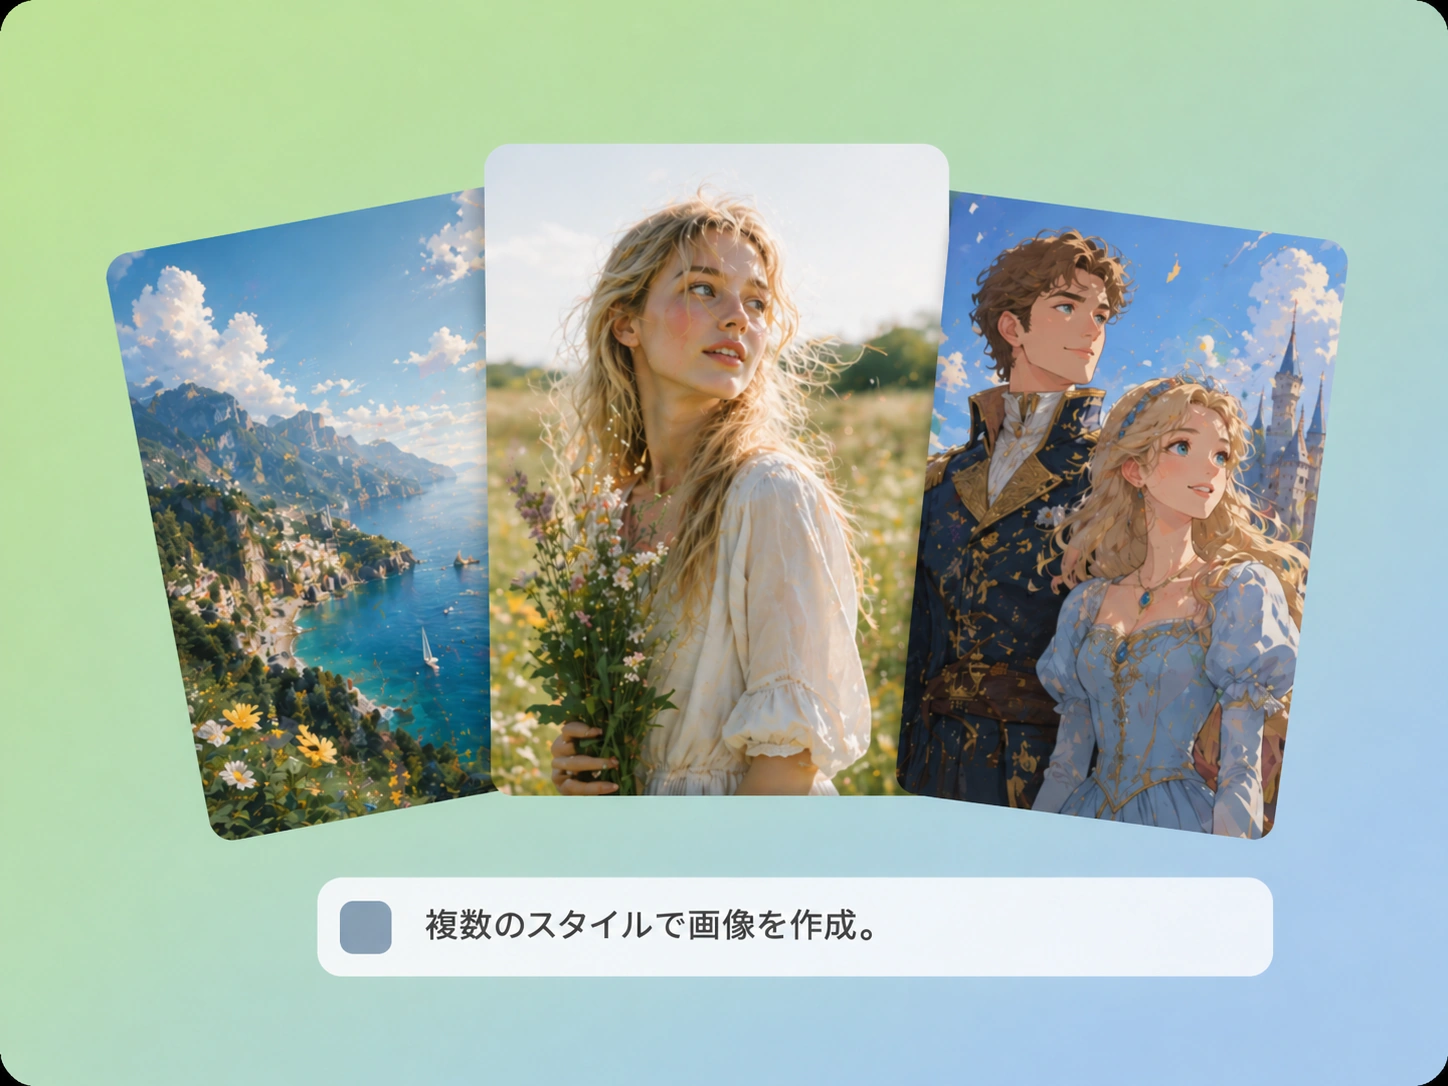
GPT-Image-2 の全機能範囲、Pexo 経由でアクセス可能
Pexoでは、1つの会話画面からGPT-Image-2の6つの主要機能をすべて使えます。作りたいものを伝えると、Pexoが適切な機能を自動で適用します。
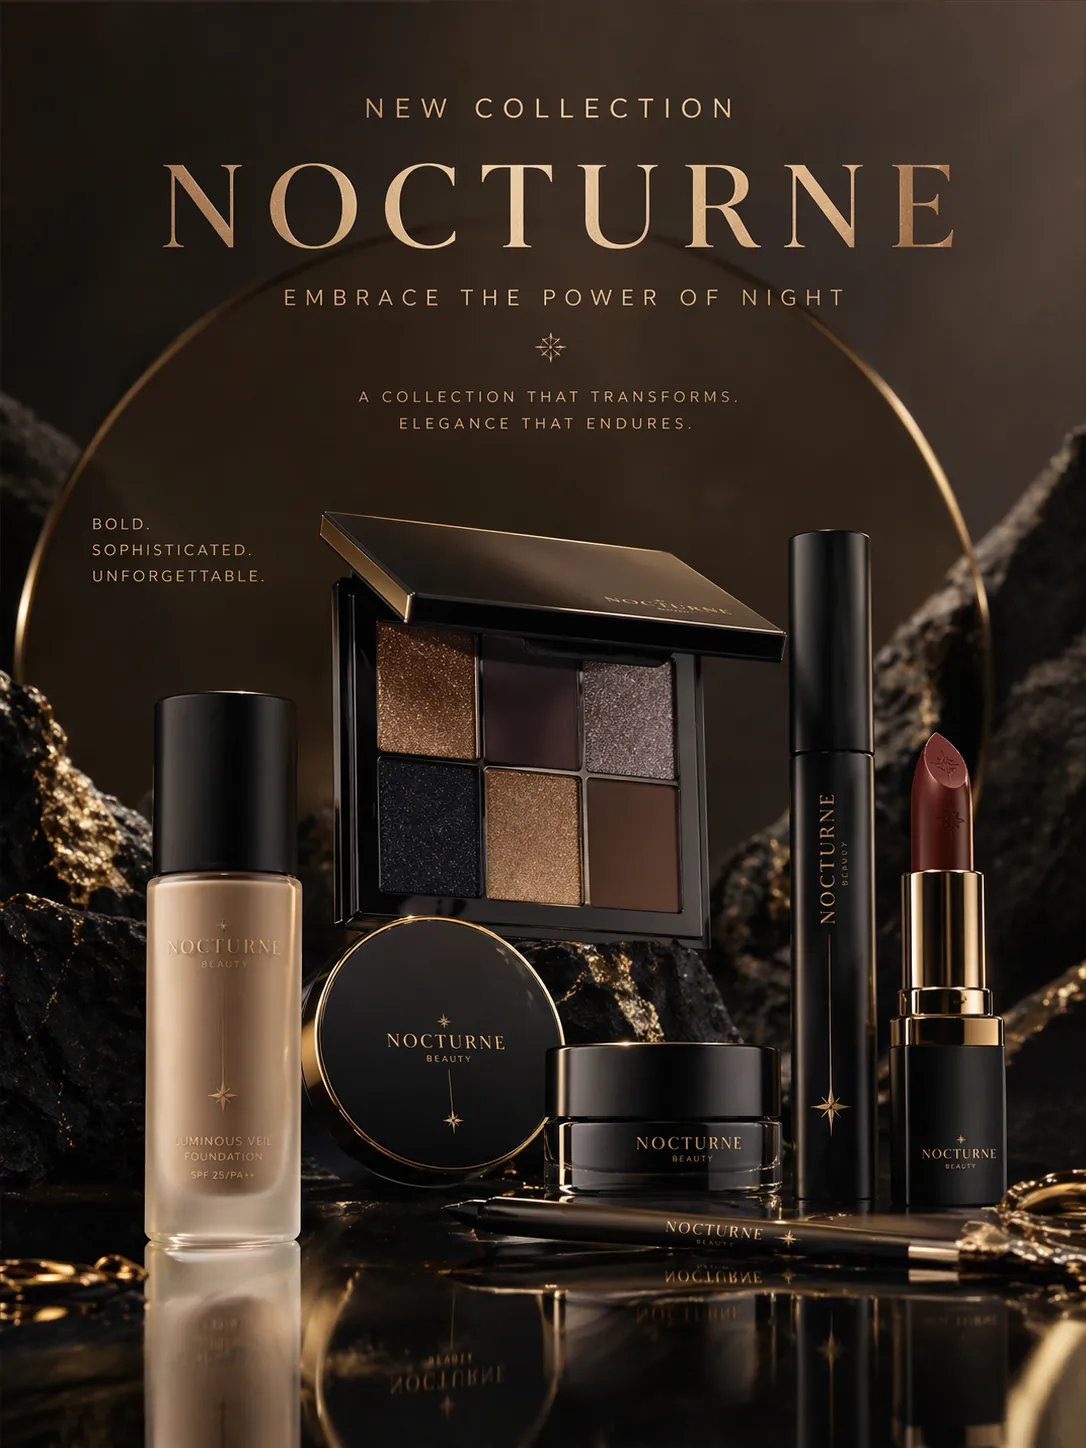
生成された画像内の読みやすく正確なテキストがついに解決
GPT-Image-2は、画像内の文字も重要な出力として扱い、看板、ラベル、バナー、UI要素に、正しい字形、整った間隔、意味の通る文字列を生成します。デザイナーやマーケティング担当者にとって、制作上の大きな障害を解消します。生成結果を下書きではなく、完成した素材として使えます。
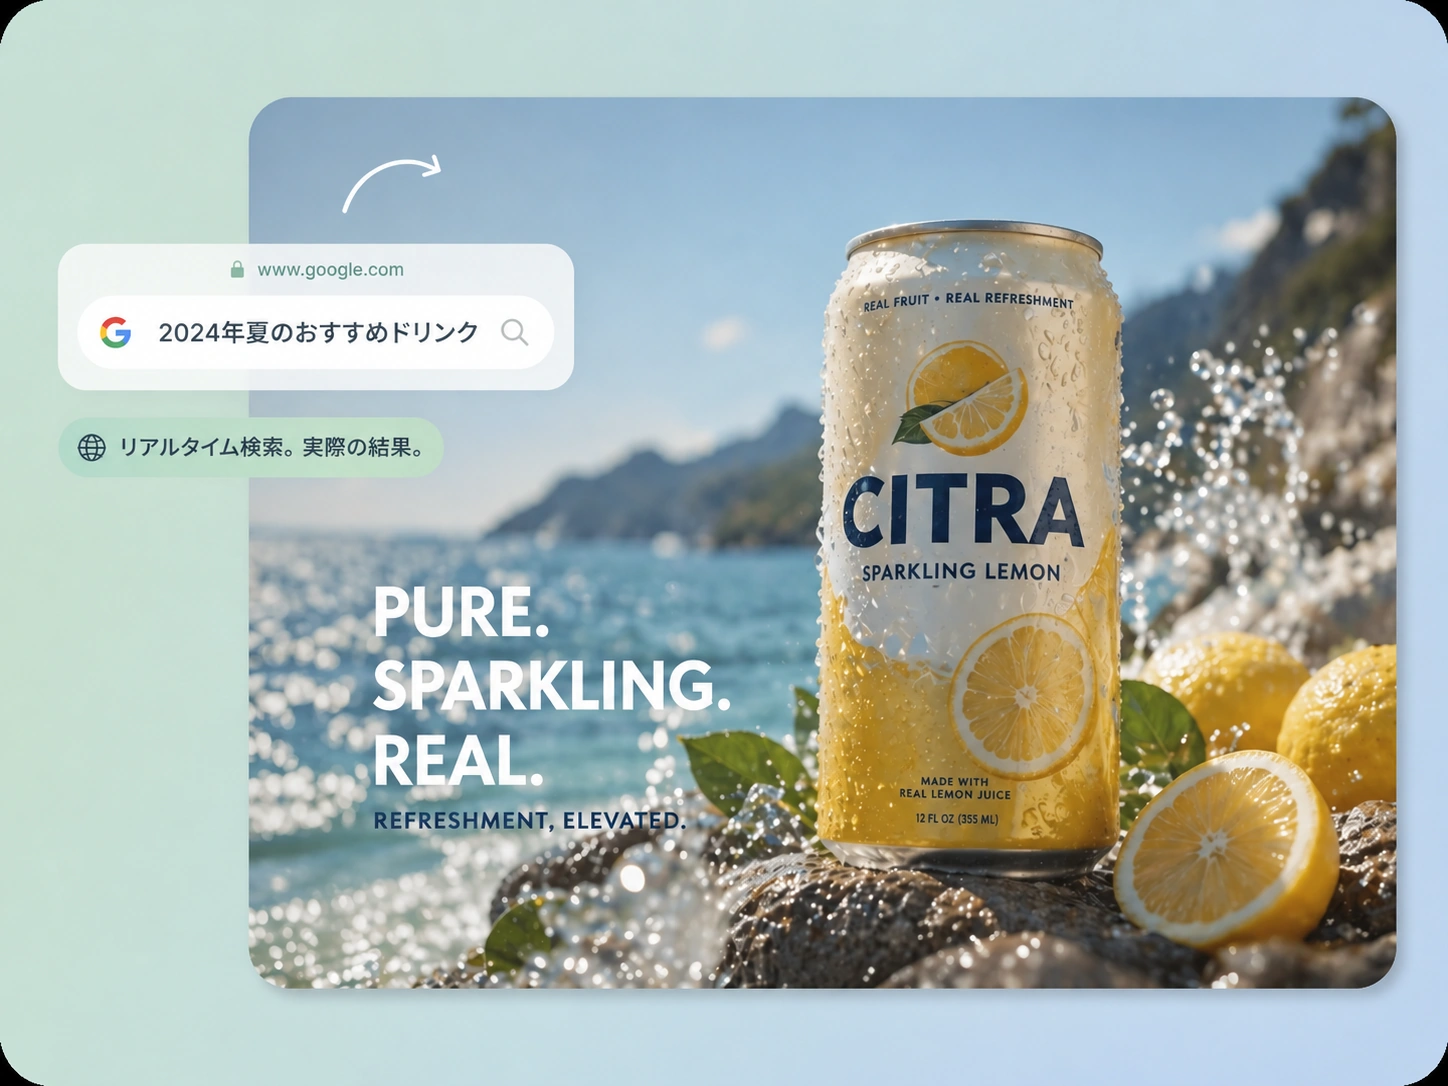
現在の実世界の情報に基づいて生成された画像
多くの画像モデルは学習データだけを基に生成するため、実在の商品、最近の出来事、現在のブランド素材の描写は、よくても近似にとどまります。GPT-Image-2はWeb検索を利用し、実際の最新情報に基づいて生成します。そのため、特定の商品や場所を、現在の実際の姿に沿って描けます。
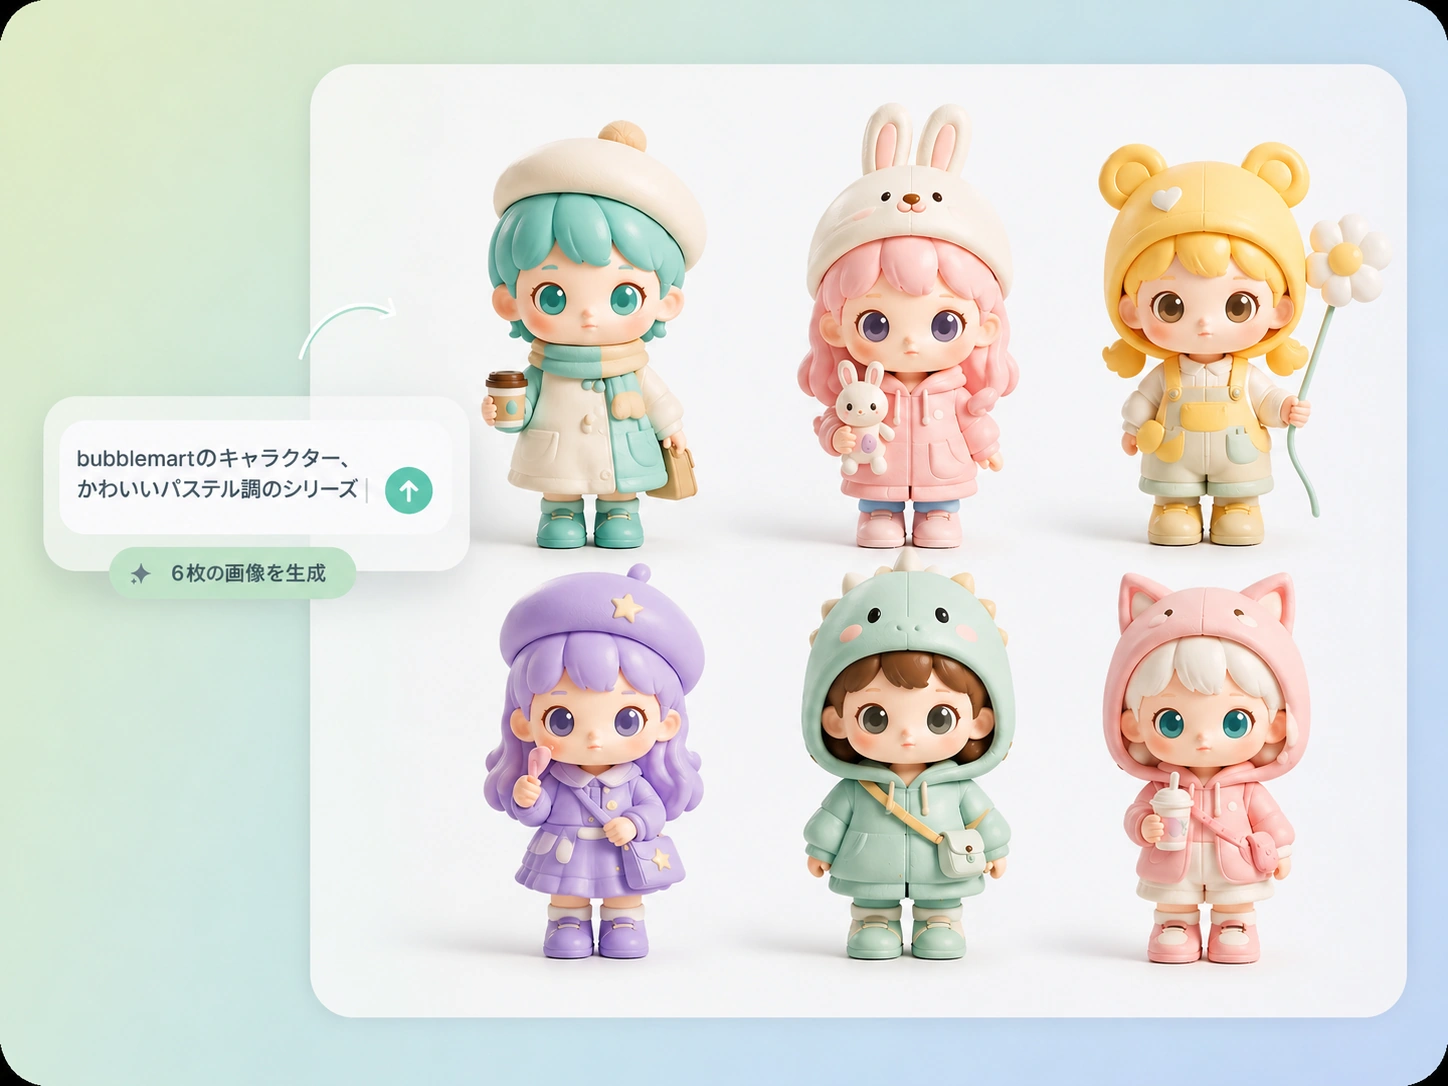
1 回のリクエストで複数の画像を生成し、一貫したスタイルを維持
GPT-Image-2は、1つの説明から複数の画像を生成できます。アイデアを一度説明すると、選択できる複数の結果を受け取れます。Pexoでは追加設定なしで、1回の会話のやり取りで行えます。画像生成を繰り返す作業では、積み重なる時間の節約が大きくなります。
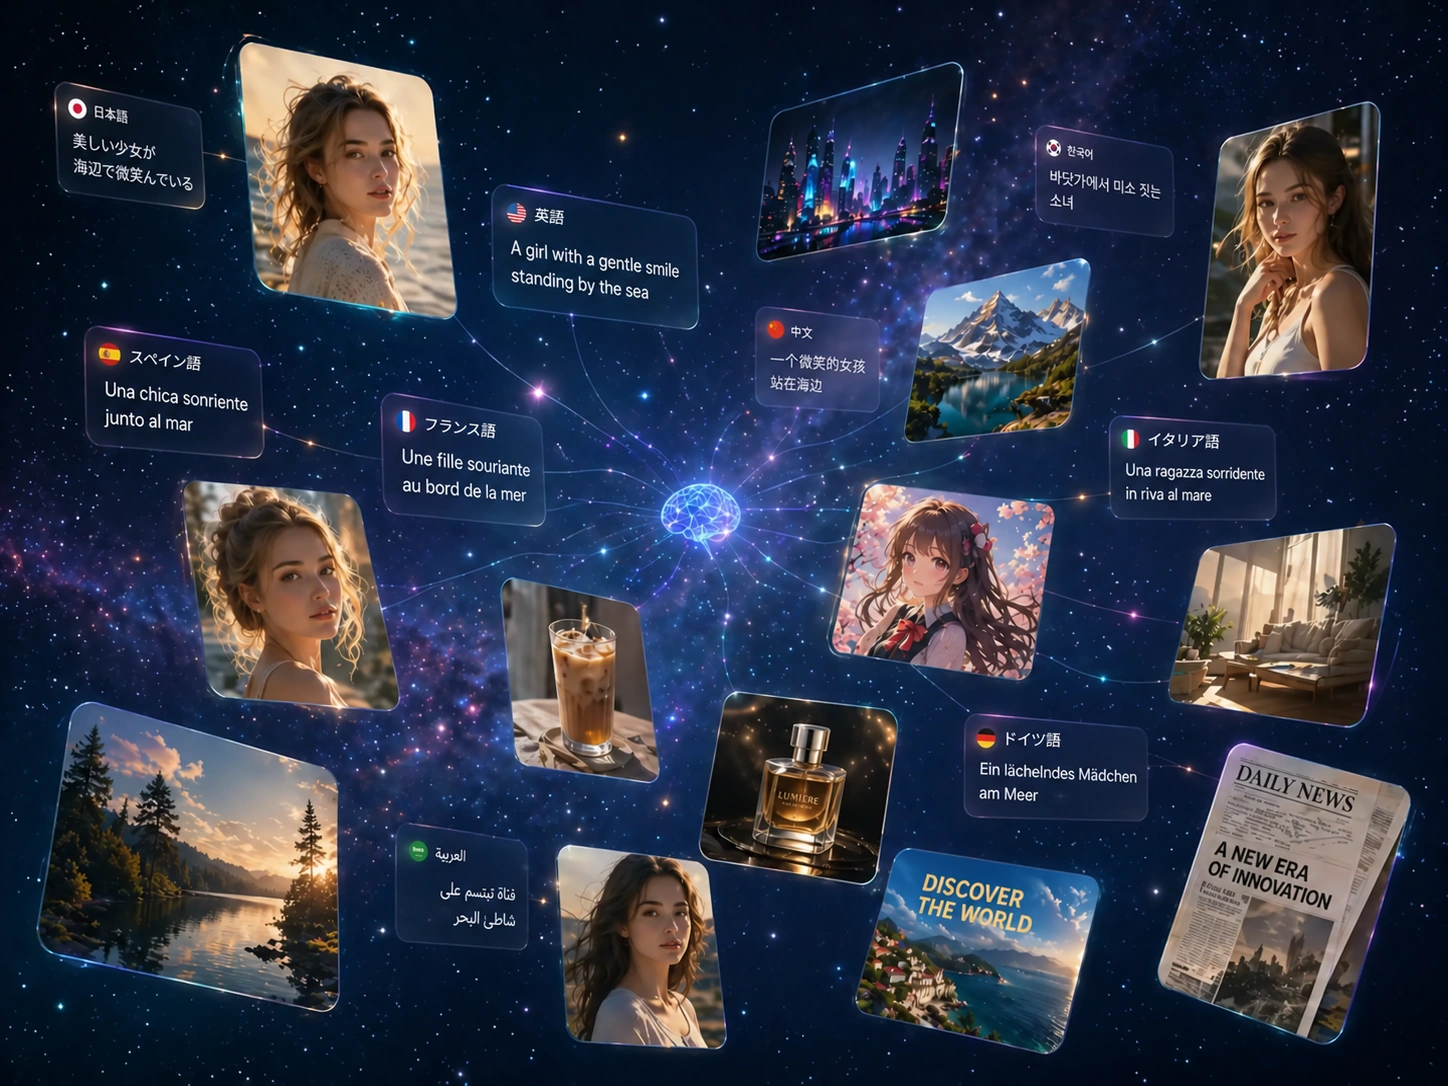
複数の言語にわたるプロンプトとテキストを理解して表示します
GPT-Image-2は複数の言語のプロンプトに対応し、日本語、韓国語、中国語、アラビア語などの非ラテン文字を、画像内に正確に描きます。英語以外で制作する人も、生成前にアイデアを翻訳する必要はありません。Pexoでは、多言語の入力も英語と同じように自然に扱えます。
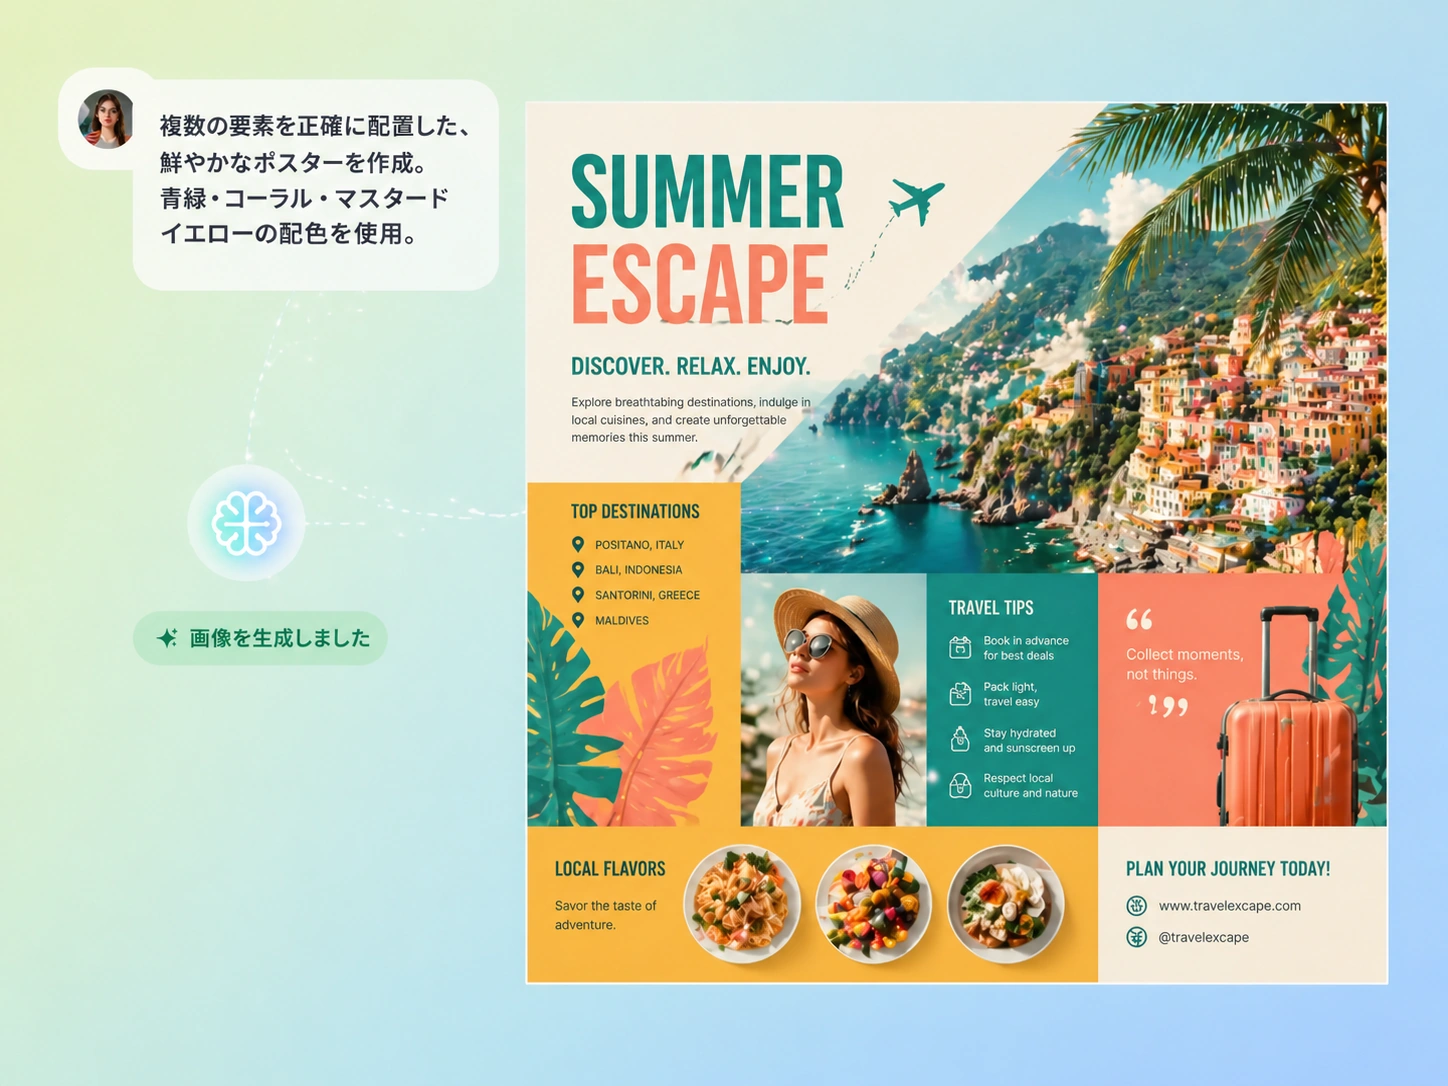
実際に要求した内容と一致する正確な出力
従来は、ユーザーの説明と画像モデルの出力の隔たりが大きく、複雑な指示を実用的に扱うのが困難でした。GPT-Image-2は、その隔たりを大きく縮めます。Pexoでは、普段の言葉による指示でも、同じ水準の忠実さを利用できます。
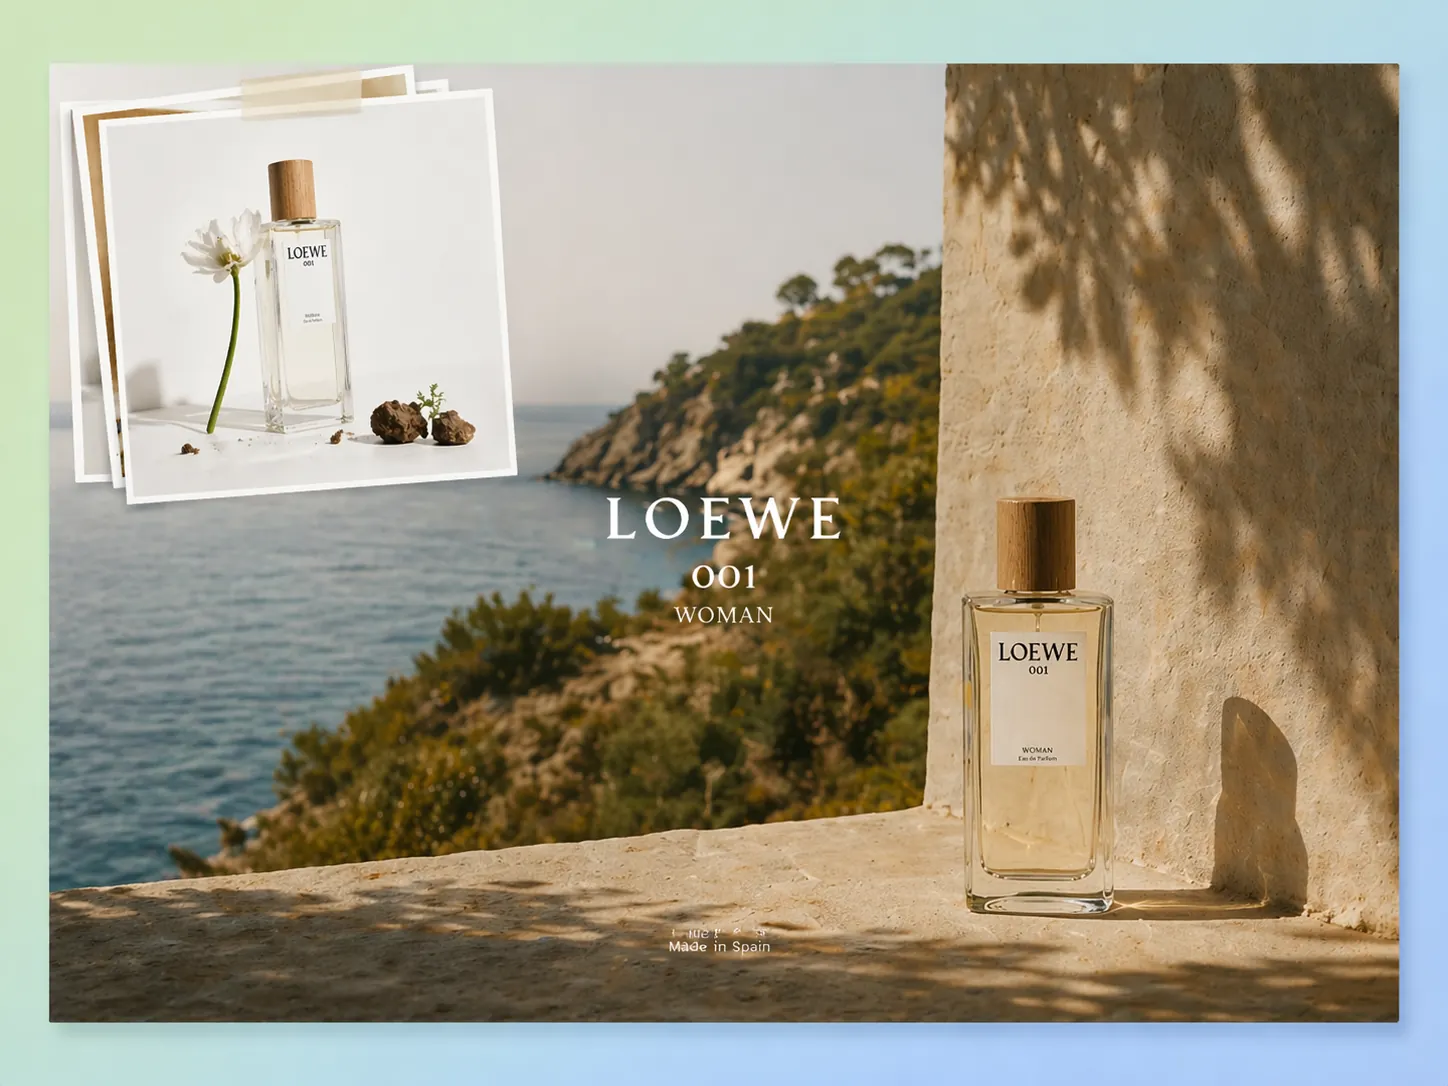
事実に忠実に描かれた製品、場所、ブランド
Web検索による根拠づけと、指示への高い忠実さを組み合わせることで、GPT-Image-2は実在の被写体を商用品質の精度で生成できます。商品のパッケージ、ソフトウェアの画面、店頭、ブランド素材を、学習データからの推測ではなく、実際の姿に沿って描きます。ECチーム、マーケティング担当者、提案資料を作る創業者にとって、適した選択肢です。
GPT-Image-2 と DALL-E 3、Imagen 4、Midjourney v7 の比較: テキスト レンダリング、Web 検索、命令の忠実度の比較
ここでは、モデルの機能を比較しています。以下には、GPT-Image-2の性能が優れている項目だけでなく、競合モデルがまったく対応していない機能も含まれます。
| 機能 | GPT-Image-2 | DALL-E 3 | Imagen 4 | Midjourney v7 |
|---|---|---|---|---|
| 画像内テキストのレンダリング精度 | ほぼ完璧 | 一貫性がない | 強い | 限定的 |
| Web検索による情報の根拠づけを内蔵 | ✓ | — | — | — |
| リクエストごとに複数のイメージを生成 | ✓ | ✓ | ✓ | ✓ |
| 多言語プロンプトサポート | ✓ | 部分的 | ✓ | 部分的 |
| 出力での非ラテン文字レンダリング | ✓ ネイティブ | 一貫性がない | ✓ | 限定的 |
| 指示への忠実さ | 高 | 中程度 | 高 | 中程度 |
| 現実世界の製品とブランドの正確性 | 高い(Web情報に基づく) | 低い | 中程度 | 低い |
| ネイティブの会話型インターフェイス | ✓ (ChatGPT + Pexo) | ✓(ChatGPT) | — | — |
| Pexoでの利用(普段の言葉で入力) | ✓ | ✓ | ✓ | ✓ |
| 開発者向けAPIの提供 | ✓ | ✓ | ✓(Vertex AI) | — |
出典: GPT-Image-2 — OpenAI の発表 · GPT-Image-2 — OpenAI API ドキュメント · DALL-E 3 — OpenAI 製品ページ · Imagen 4 — Google DeepMind · Midjourney v7 — Midjourney
Pexo で GPT-Image-2 を使用する方法: 3 つのステップ、セットアップなし
OpenAIアカウント、APIキー、技術的な知識は必要ありません。Pexoがモデルの選択、生成、納品まで対応するので、作りたいものに集中できます。
作りたい内容を伝える
対応言語のいずれかで、作りたい内容を普段の言葉で入力します。説明の細かさは自由です。決まった形式やモデルの選択は不要です。Pexoが意図を読み取り、残りの処理を行います。
PexoがGPT-Image-2で生成
PexoがリクエストをGPT-Image-2に送り、精度の向上につながる場面でWeb検索を利用し、すべての生成パラメータを自動で処理します。設定作業は不要です。モデルが動作し、数秒で結果が届きます。
完成した画像をダウンロード
画像はそのまま使える状態で届きます。GPT-Image-2は指示への忠実さが高いため、通常は最初の生成結果をそのまま採用できます。修正と再生成を繰り返す作業から解放されます。
PexoのGPT-Image-2についてのよくある質問
GPT-Image-2とは何ですか?DALL-E 3との違いは?+
GPT-Image-2は、OpenAIの次世代画像モデルです。DALL-E 3のように別システムとして動作するのではなく、GPTのアーキテクチャに直接組み込まれています。主な違いは、ほぼ完璧な画像内文字の描画、実世界の正確な描写を支えるWeb検索、複数の条件を含む複雑な指示に対する大幅に高い忠実さです。
GPT-Image-2は画像内に正確な文字を描けますか?+
はい。DALL-E 3やGPT-Image-1などの従来モデルから大きく進歩した点の1つです。複数の単語を含むラベル、看板、UI要素、キャプションを、整った字形と文字間隔で描きます。これにより、画像内の文字を初めて安定して実用に使えるようになりました。
GPT-Image-2はWeb検索で実世界の情報を画像生成に反映しますか?+
はい。実在の商品、場所、ブランド素材を生成するときに、現在のWeb情報を参照できます。学習データからの近似ではなく、現在の実際の姿を反映した出力になります。DALL-E 3、Imagen 4、Midjourney v7にはない機能です。
OpenAIアカウントなしでGPT-Image-2を使うには?+
Pexoから利用できます。OpenAIアカウント、APIキー、技術的な設定は不要です。作りたいものを普段の言葉で説明すると、Pexoがモデルの選択、生成、納品を行います。
GPT-Image-2は1つのプロンプトから複数の画像を生成できますか?+
はい。GPT-Image-2は1回のリクエストで複数の画像を生成できます。1枚ずつ再生成する代わりに、アイデアを一度伝え、比較できる複数の結果を受け取れます。Pexoでは、1回の会話のやり取りで実行できます。
GPT-Image-2のプロンプトと画像内文字は、どの言語に対応しますか?+
GPT-Image-2は複数の言語のプロンプトに対応し、日本語、韓国語、中国語、アラビア語などの非ラテン文字を画像内に正確に描きます。母語で説明し、その言語の文字を正しく描いた画像を受け取れます。
GPT-Image-2 は Pexo で無料で使用できますか?+
Pexo は、他の主要な AI モデルとともに GPT-Image-2 へのアクセスを含む無料プランを提供しています。現在のプランの詳細と生成回数の上限については、Pexo の価格ページを確認してください。
製品またはブランドのイメージを生成する GPT-Image-2 はどの程度正確ですか?+
比較対象となる多くのモデルより正確です。内蔵のWeb検索によって、学習データから推測するのではなく、現在の実世界の情報を参照できるためです。指示への高い忠実さも備え、実物との正確さが重要なEC、マーケティング、商品の可視化に実用的な選択肢です。
PexoのGPT-Image-2で、言葉を画像に
今利用できる最高の画像モデルを、1文の説明で使えます。