01 / シーンの演出
文章から動画を生成
見たいアクションを書きます。
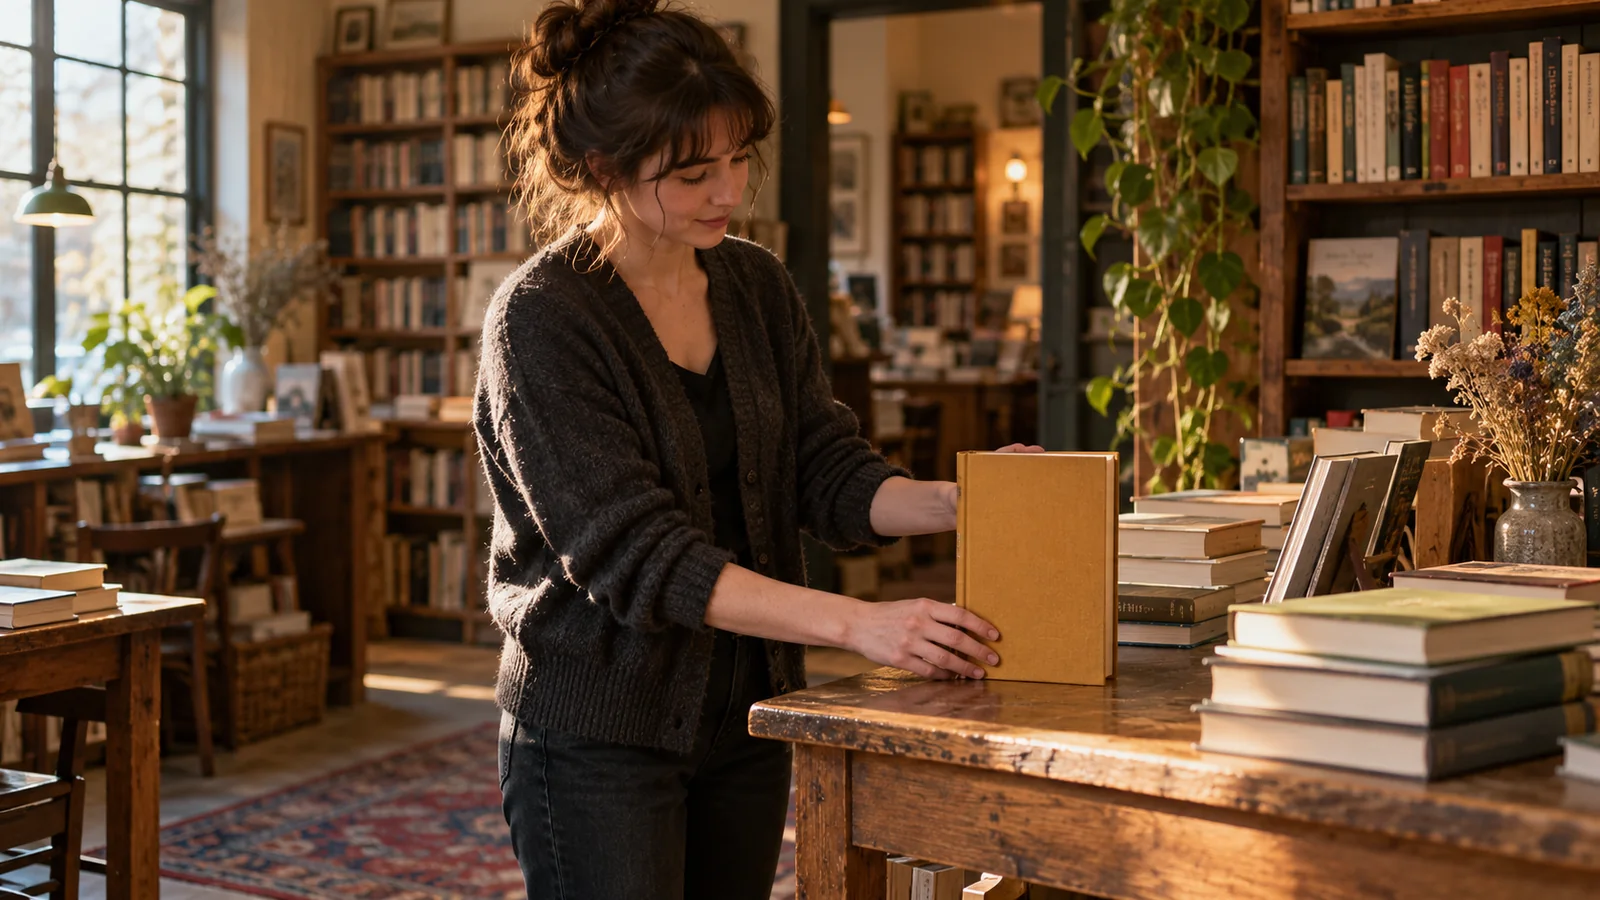
Veo 3は、テキストの説明から短いシーンを作ります。画面に映る人物や物、動作が起きる場所、カメラの追い方を指定します。書店員が黄土色のハードカバーを陳列台に置く場面なら、ショットの中の出来事が明確になります。表紙へゆっくり近づくことで、その動作を視覚的に強調できます。
同じ指示の中で、被写体、動作、舞台、カメラの動きを指定します。
Veo 3は、生成するシーンに音声の同時生成を導入したGoogle DeepMindの動画モデルです。対応する制作方法では、文章による指示や画像を基に、画面内の動作とセリフ、効果音、環境音を組み合わせられます。
Googleは、初代Veo 3.0のVertex AIエンドポイントを提供終了とし、Veo 3.1を推奨しています。
映像とともに音声を生成
シーンを確立する 2 つの方法
標準版と、生成速度を重視したバリエーション
01 / シーンの演出
見たいアクションを書きます。
Veo 3は、テキストの説明から短いシーンを作ります。画面に映る人物や物、動作が起きる場所、カメラの追い方を指定します。書店員が黄土色のハードカバーを陳列台に置く場面なら、ショットの中の出来事が明確になります。表紙へゆっくり近づくことで、その動作を視覚的に強調できます。
同じ指示の中で、被写体、動作、舞台、カメラの動きを指定します。
02 / 視覚的な出発点
静止画に次の瞬間を与えます。
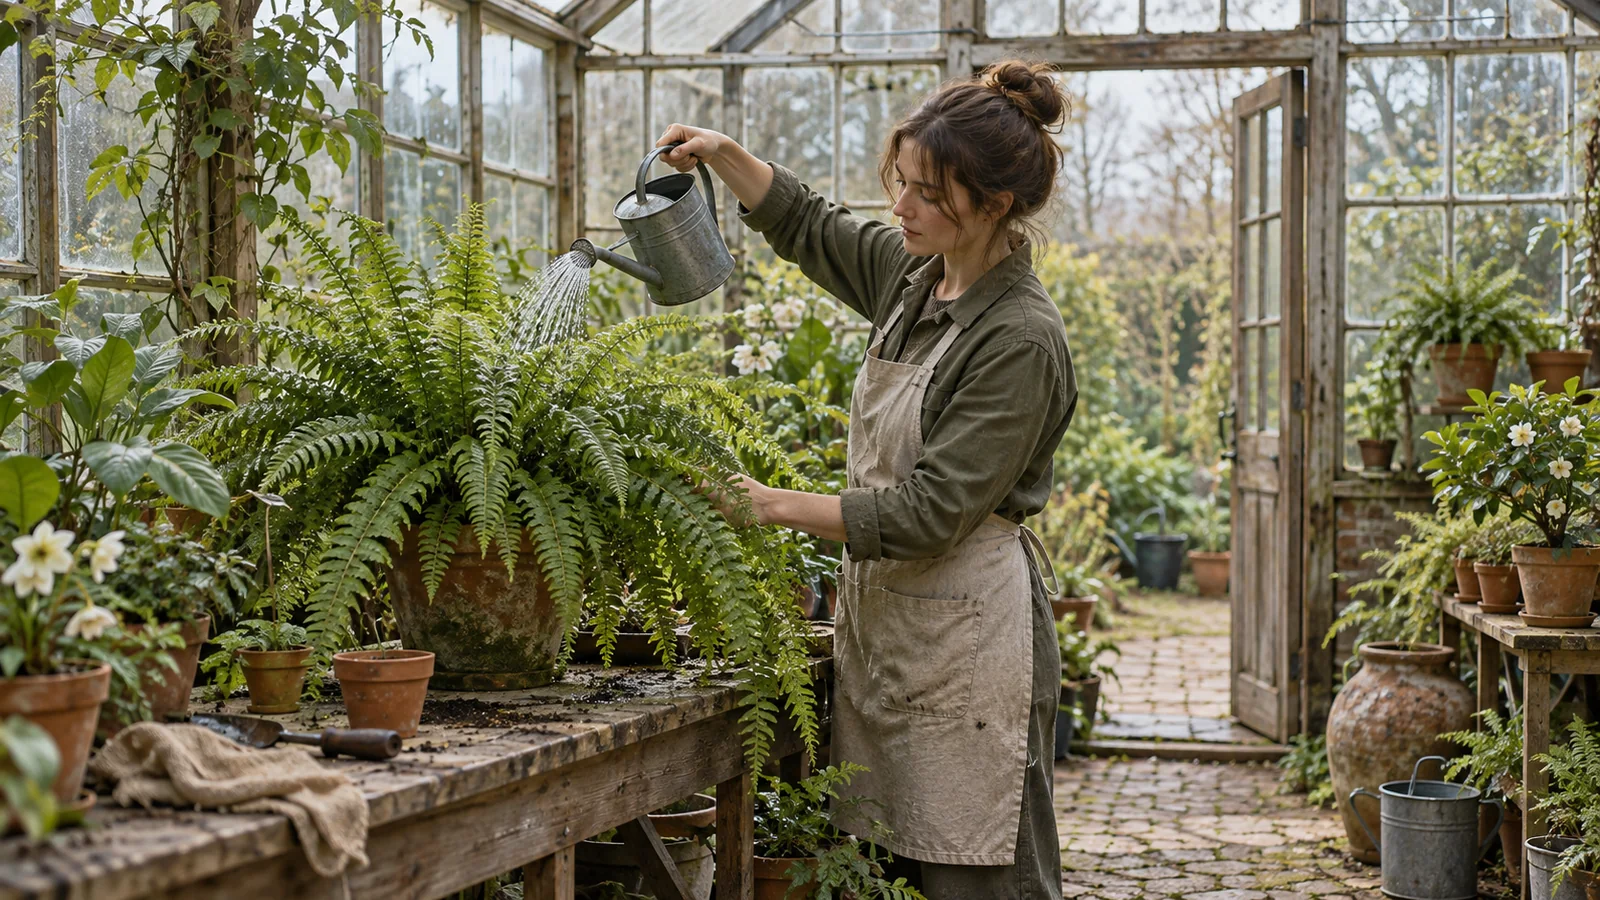
Googleは、GeminiとFlowに、Veo 3を使った写真からの動画生成を導入しました。画像で人物、舞台、構図を決め、追加の説明で次の出来事を指示します。この温室の場面では、じょうろ、水の流れ、シダの葉に動きを絞ります。
開始画像にすでに映っている物と結びつけて、動きを指定します。
03 / シーン内のサウンド
視聴者が見ているものだけでなく聞いているものを説明します。
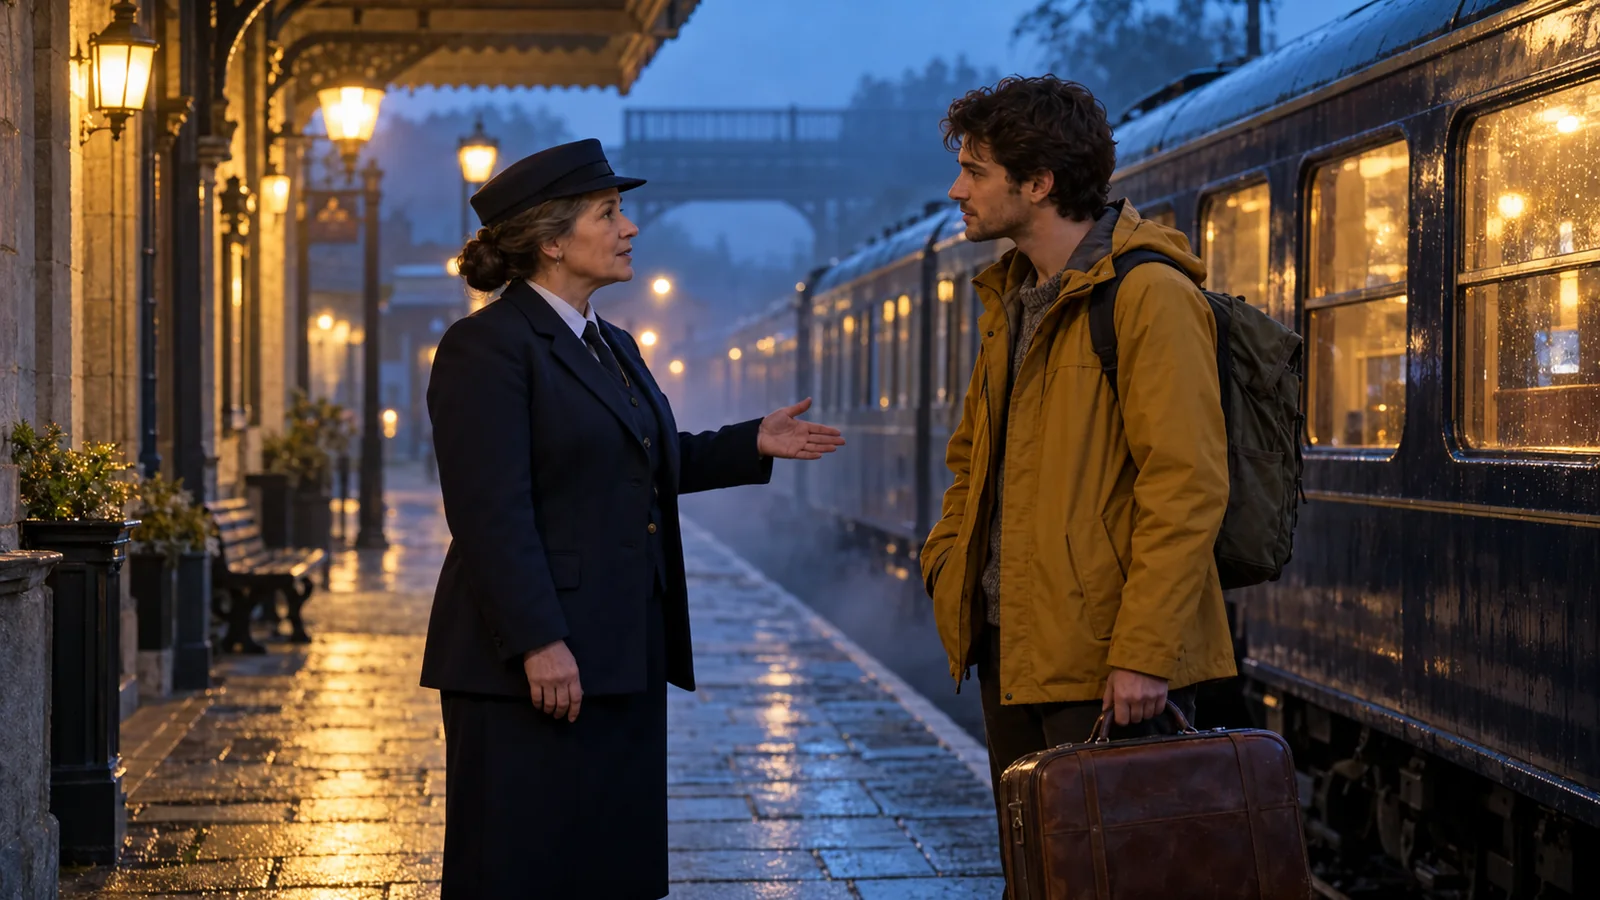
Veo 3は、発話、環境音、動作の効果音などを映像と一緒に生成します。車掌のセリフ、ホームに降る雨、列車の低い待機音など、音ごとに発生源を決めます。セリフを短くすれば、人物のしぐさや周囲の雰囲気を見せる余地が生まれます。
話者が 1 人で、セリフが短いため、意図したやり取りを理解しやすくなります。
初代Vertex AI Veo 3.0のGoogle公式仕様には、次の出力形式が記載されています。
長さ
4/6/8秒アクションが定義された短いクリップ。
向き
16:9または9:16横長・縦長の構図。
解像度
720p / 1080pVeo 3.0の仕様に記載された出力サイズ。
フレームレート
24fps一定のフレーム間隔で出力。
どちらもVeo 3.0シリーズのモデルです。Fastは試作をすばやく繰り返すために導入され、元のモデルは標準的な生成に使われました。
| 比較項目 | Veo 3 | Veo 3 Fast |
|---|---|---|
| テキストからの動画生成 | 書かれたシーンの概要 | 書かれたシーンの概要 |
| オーディオ | ネイティブサウンド生成 | ネイティブサウンド生成 |
| 文書化されたクリップの長さ | 4、6、または8秒 | 4、6、または8秒 |
| 仕様に記載された解像度 | 720p / 1080p | 720p / 1080p |
| ワークフローの重視 | 標準的な生成 | 反復の高速化 |
| 現在のVertex AIでの後継モデル | Veo 3.1 | Veo 3.1 Fast |
商品の物語、映画のような一瞬、写真を動かした映像の連なりに使える、Pexoの制作方法を紹介します。
すべての指示に視覚的または聴覚的な役割があると、焦点を絞ったシーンの演出が容易になります。
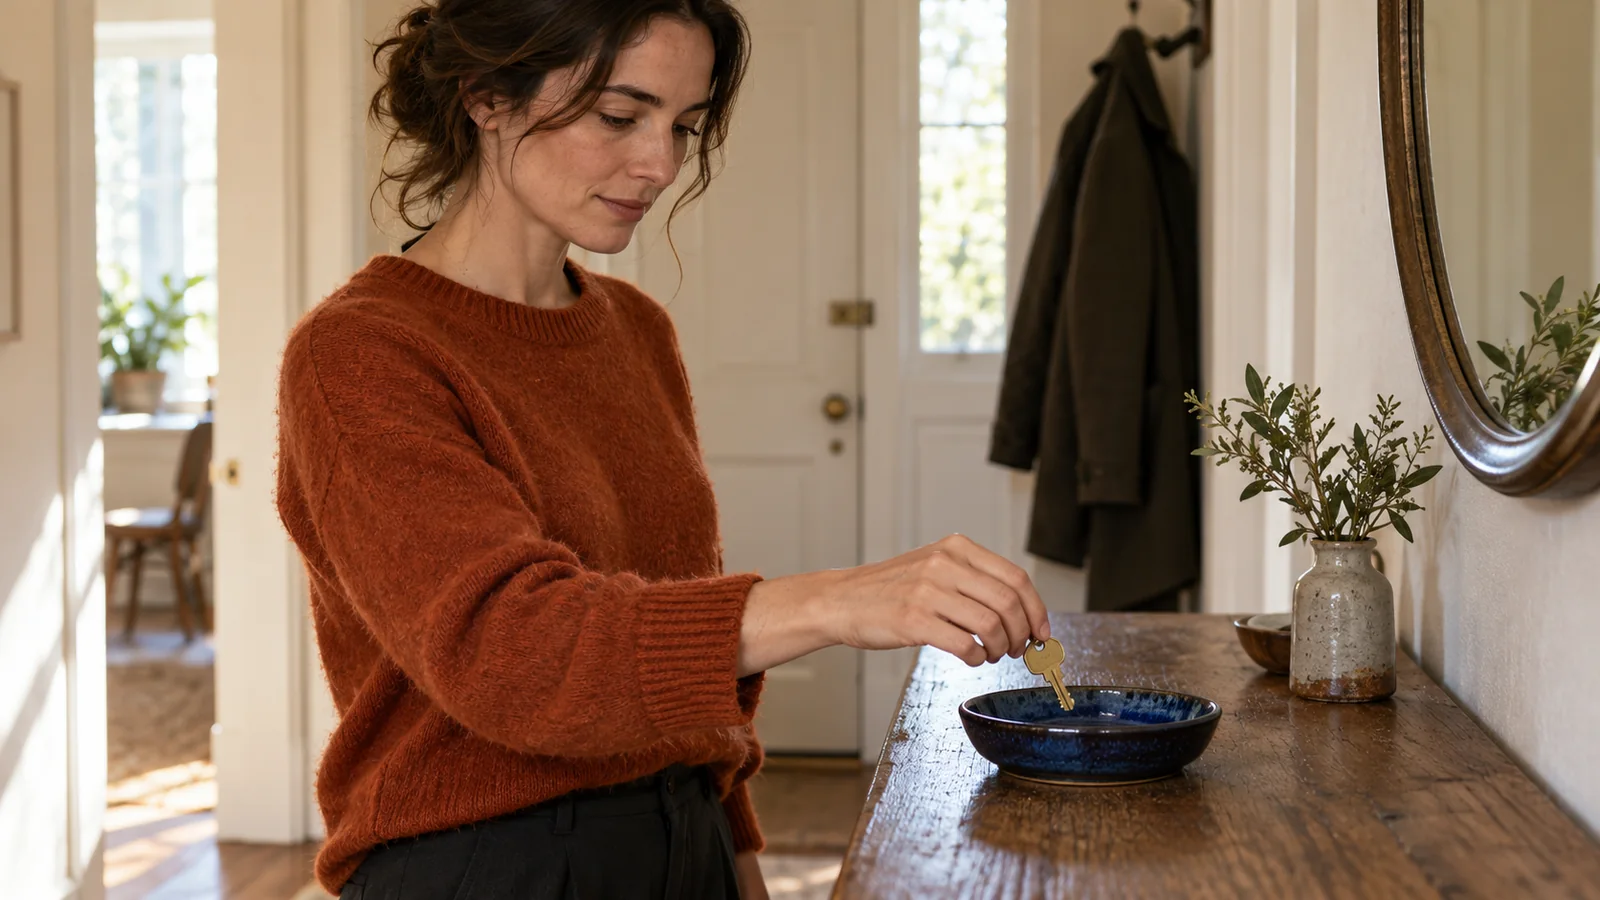
01
静かな玄関ホール、オーク材のコンソール、青い陶器の皿、そして朝の光の中で真鍮の家の鍵を持つ女性。
02
彼女は鍵をそっと皿に置きます。カメラが近づき、彼女の手とセラミックの縁の上に止まります。
03
鍵が皿に触れる小さな金属音、袖の擦れる音、静かな室内の環境音。音がした後に短い間を置く。
Veo 3は、Google DeepMindが2025年5月に発表した動画生成モデルです。大きな特長は音声の同時生成で、セリフ、効果音、背景の音を動画と一緒に生成できます。
はい。Googleは2025年7月、GeminiとFlowにVeo 3を使った写真からの動画生成を導入しました。開始画像で構図を定め、文章による説明で動きと音を指定します。
初代Vertex AI Veo 3.0の仕様には、4秒、6秒、8秒のクリップが記載されています。Geminiの写真からの動画生成の発表では、音声付きの8秒動画が紹介されました。
はい。Veo 3は、セリフ、環境音、効果音の同時生成に対応します。セリフでは話者と話す言葉を指定し、ほかの音もシーン内の物や動作と結びつけて説明します。
いいえ。異なる世代のモデルです。Googleは初代Veo 3.0のVertex AIエンドポイントを提供終了とし、開発者にVeo 3.1またはVeo 3.1 Fastを案内しています。
動画モデルは、入力から個々のクリップを生成します。動画エージェントはプロジェクト全体を扱い、制作指示、シーン、素材、修正、最終編集の整理を支援します。1つのショットが必要なのか、一連の動画制作を進めたいのかに応じて選びます。